
マルチエージェントでAIを増やすと、仕事は速くなるのでしょうか。費用や危険も気になる所です。
複数のAIが役割を分け、協力して一つの仕事を進める仕組みです。
- 指揮する係を置く形、横で協力する形、競う形があります。
- 開発元Anthropicの発表では、使用量は普通の会話の約15倍です。
- 最初は一つで試し、分ける理由がある仕事だけ増やします。
同志社大学を卒業後、設備メーカーの海外営業を経て2016年に独立。旅行・医療などのメディアを自ら運営し、SEOとWeb広告で検索上位を数多く獲得してきました。いまはWebマーケティングのスクールと法人研修を運営しながら、11部署57名のAIエージェントと会社を回しています。
公的な認定・承認:神奈川県 経営革新計画 承認/経済産業大臣認定講座/厚生労働大臣指定講座/経済産業省 リスキリング補助事業者
目次
マルチエージェントとは?1体のAIエージェントとの違い
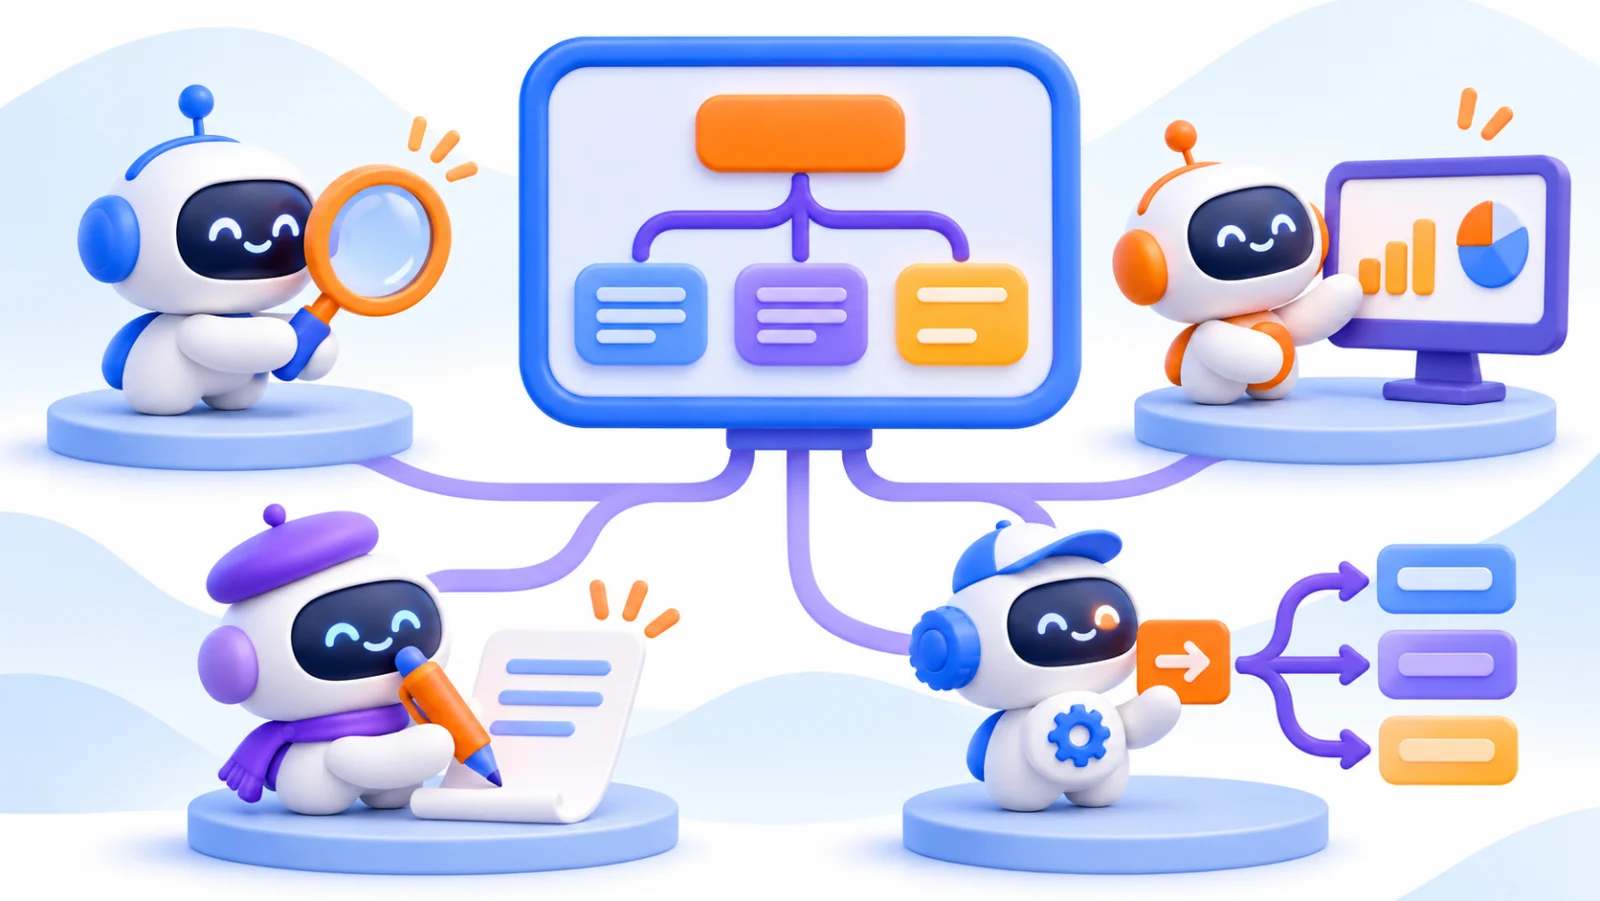
マルチエージェントは、複数の担当AIに仕事を分ける仕組みです。司令塔が担当を束ねる構成もあります。
国の言い方
国の定義では、AIエージェントは目標に向かって環境を感知し、自律的に行動します。脚注18のエージェンティックAIは、より広い考え方です。複数のAIが自律して判断し、行動する目標主導の仕組みです。エージェントは仕事の係、司令塔は現場監督と考えると分かります。
国のガイドラインで、定義と脚注を読む画面です。
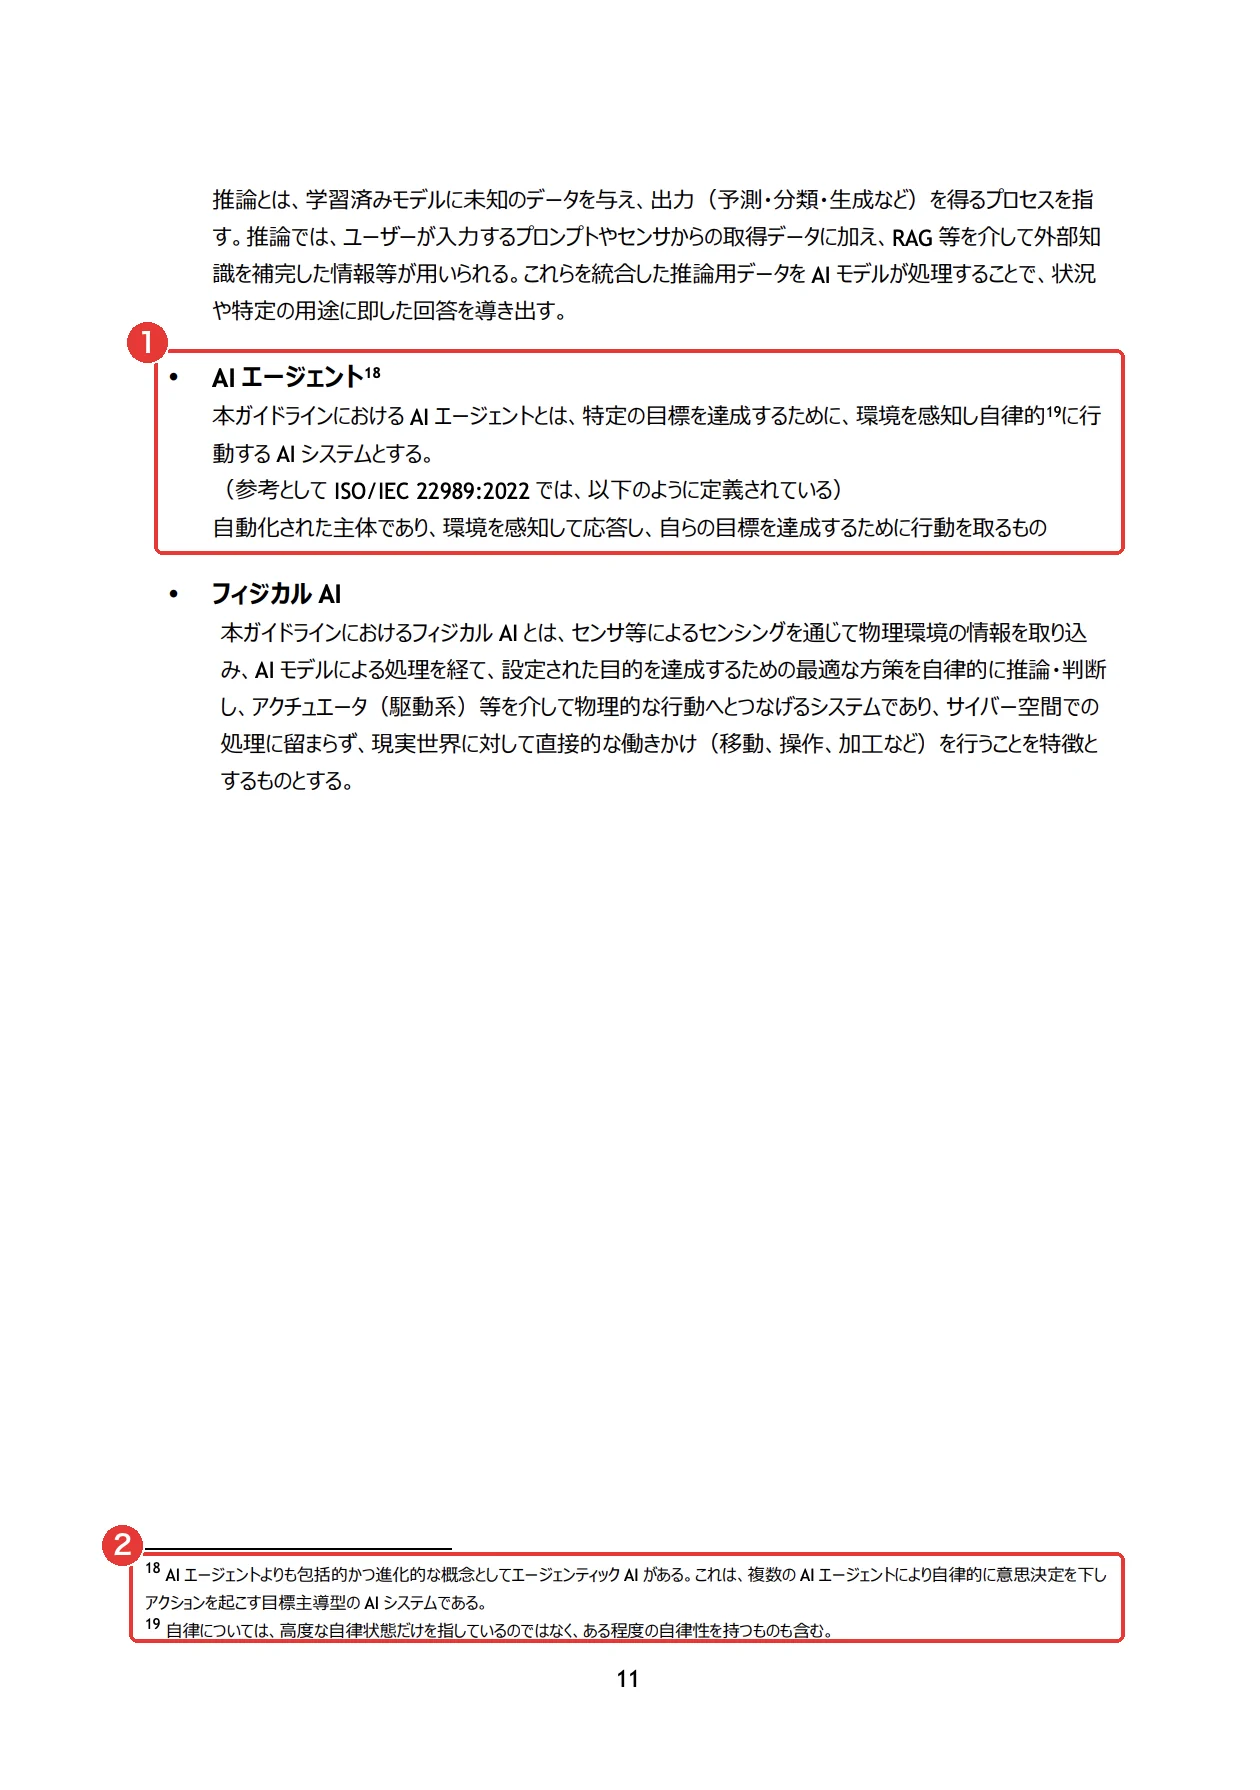
- 1AIエージェントの定義(特定の目標を達成するために、環境を感知し自律的に行動するAIシステム)
- 2脚注18:AIエージェントよりも包括的かつ進化的な概念としてエージェンティックAI(複数のAIエージェントにより自律的に意思決定を下しアクションを起こす目標主導型のAIシステム)。脚注19:自律は程度の差を含む
赤枠1で定義の三要素、赤枠2で脚注18を確かめます。製品名だけで判断せず、複数の担当が何をするかを書き出します。
OECDの言い方
OECD.AIも、複数が協調し仕事を分ける仕組みを説明しています。単に同じ質問を複数のAIへ送るだけとは分けて考えます。誰の結果を誰が受け取り、どう次へ進めるかが要点です。
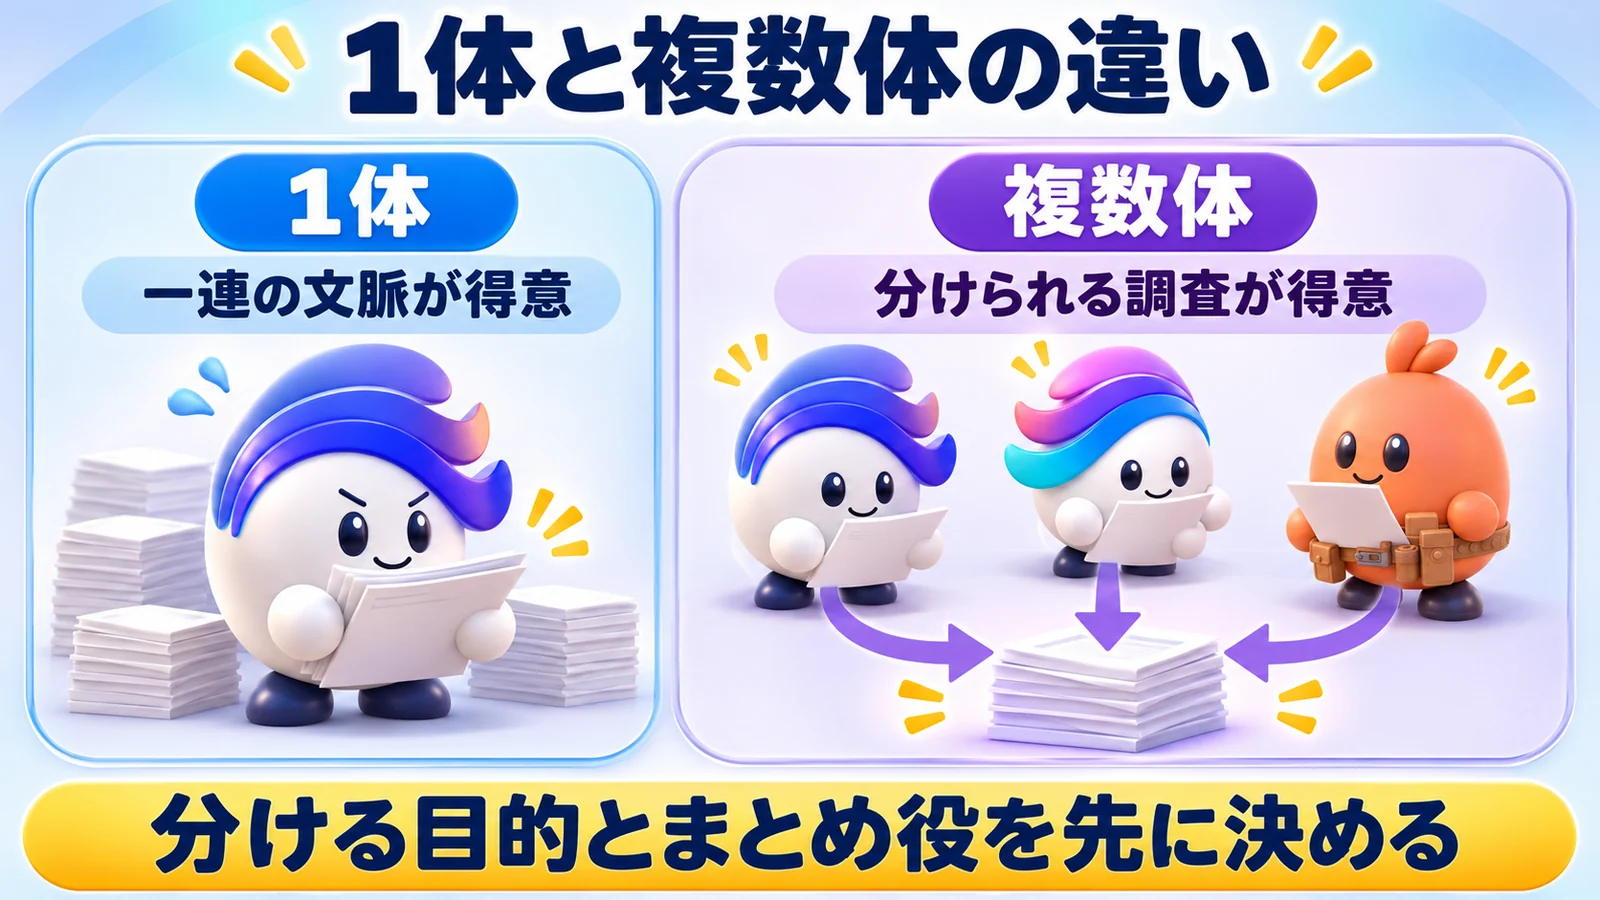
1体と複数体の違い
Anthropicの研究システムでは、担当を並列に動かします。並列とは、料理で別の人が同時に下ごしらえする形です。順番待ちを減らせる一方、結果をまとめる仕事が増えます。
| 比較 | 1体 | 複数体 |
|---|---|---|
| 人数 | 一つの担当 | 役割を分担 |
| 得意な仕事 | 一連の文脈を使う | 独立した調査 |
| 費用 | 比較の基準にする | 通信と点検も増える |
| 失敗の追いやすさ | 経路が少ない | 担当別の記録が要る |
| 向く場面 | 小さく完結する仕事 | 分けられる仕事 |
米投資会社a16zは2026年10月、役割を絞ったAIについて発信しました。
a16zの投稿は、万能な一つより役割を持つ複数を挙げています。担当を一つに絞ると、どこで失敗したかを追いやすくなります。
基本の定義はAIエージェントとはで整理しています。一つの担当の内部はAIエージェントの仕組みへ進めます。
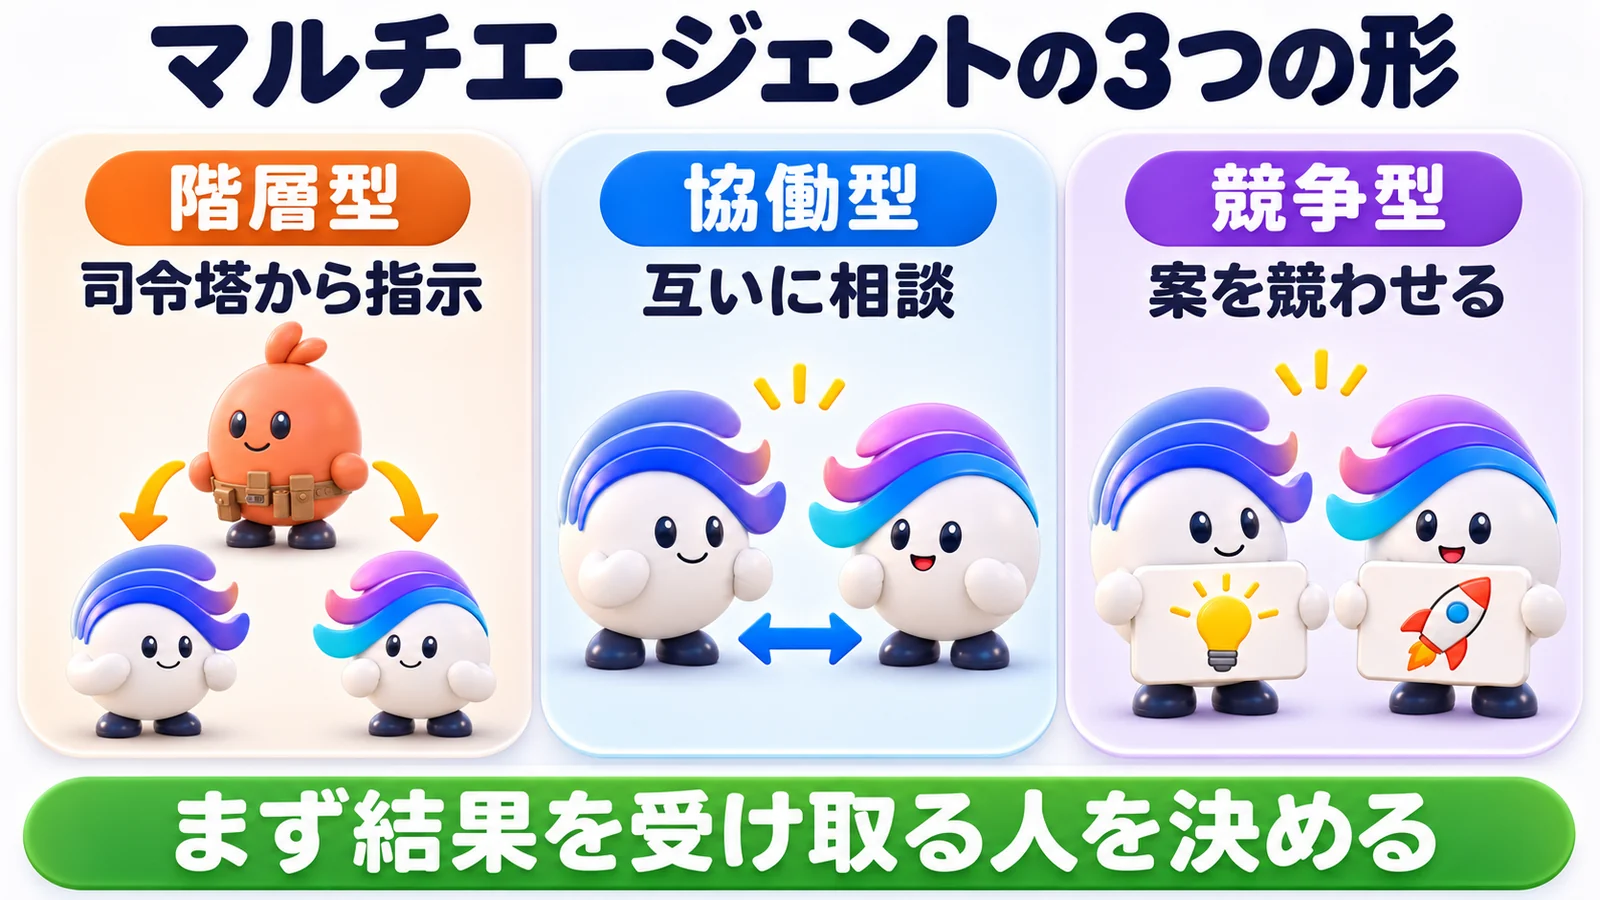
マルチエージェントの形は?階層型・協働型・競争型の3つ
総務省の検討会資料は、関係の違いで三つに整理しています。集中管理か共同作業かで、選ぶ形が変わります。
階層型
階層型は、司令塔が担当へ仕事を渡す形です。総務省の資料では、集中した管理が必要な場面に対応します。たとえば調査を分担し、編集長が一本へまとめる仕事です。
Anthropicの研究システムも、司令塔と担当を分けています。司令塔は全体の問いを持ち、担当は個別の問いを扱います。出典係も付き、司令塔が結果から最終回答をまとめます。
協働型
協働型は、複数の担当が互いに情報を渡す形です。総務省資料は共同作業が必要な場面と結び付けています。誰か一人に連絡が集中しない反面、相談の経路は増えます。
Claude Codeのエージェントチームでは、直接の連絡ができます。同じファイルを全員が直すなら、衝突への対策も必要です。担当する範囲と、結果を統合する係を決めます。
競争型
競争型は、異なる案を競わせて検討する形です。総務省資料は創造的な研究開発を利用ケースに挙げています。たとえば別々の案を出し、共通の基準で比較する場面です。
総務省の資料で、三つの形の図を読む画面です。
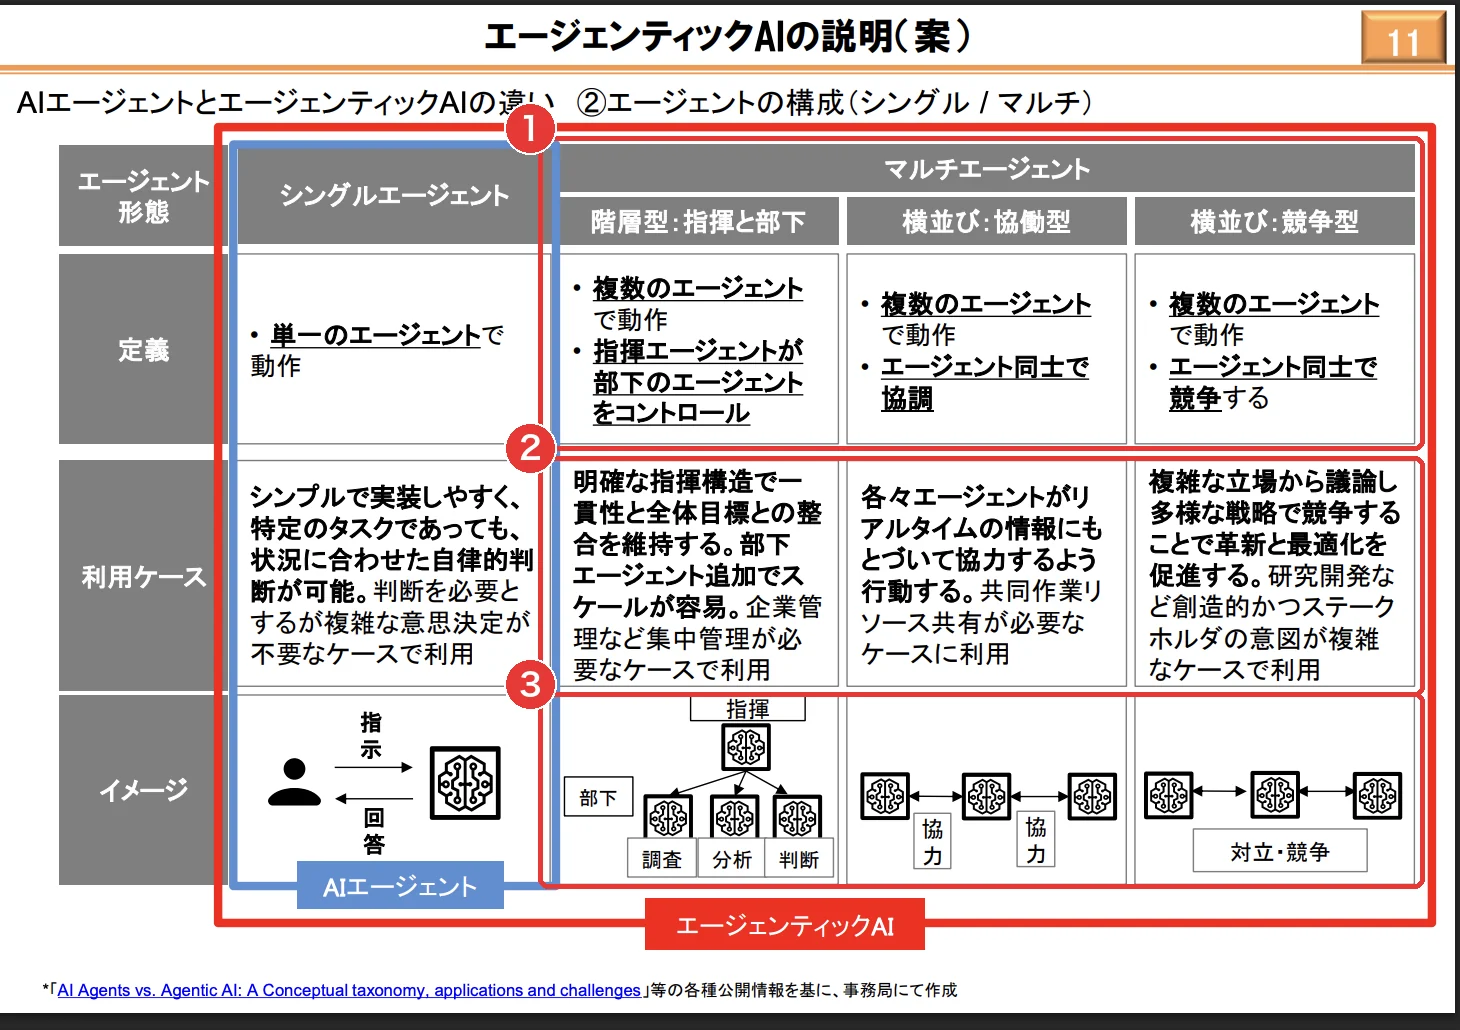
- 1マルチエージェントの3つの形(階層型:指揮と部下/横並び:協働型/横並び:競争型)と、それぞれの定義
- 2利用ケース:階層型は集中管理が要る場合、協働型は共同作業や情報の共有が要る場合、競争型は研究開発のように創造的で関係者の意図が複雑な場合
- 3イメージ図:指揮→部下/協力/対立・競争
PDFの12枚目で、関係の矢印と利用ケースを照らします。自分の仕事で必要な関係を一つ選び、担当図にします。
どれを選ぶか
総務省資料の分類は、製品を三つに振り分ける決まりではありません。同じ仕組みで、指揮と共同作業を組み合わせることも考えられます。まず結果の受取人を決め、必要な関係だけを作ります。
| 形 | 関係 | 向く場面 | 例 |
|---|---|---|---|
| 階層型 | 司令塔から指示 | 集中した管理 | 調査の統合 |
| 協働型 | 相互に相談 | 共同作業 | 担当間の調整 |
| 競争型 | 案を競わせる | 創造的な研究 | 複数案の比較 |
全体の分類はAIエージェントの種類でも整理します。
マルチエージェントはどう動く?司令塔と担当の分担
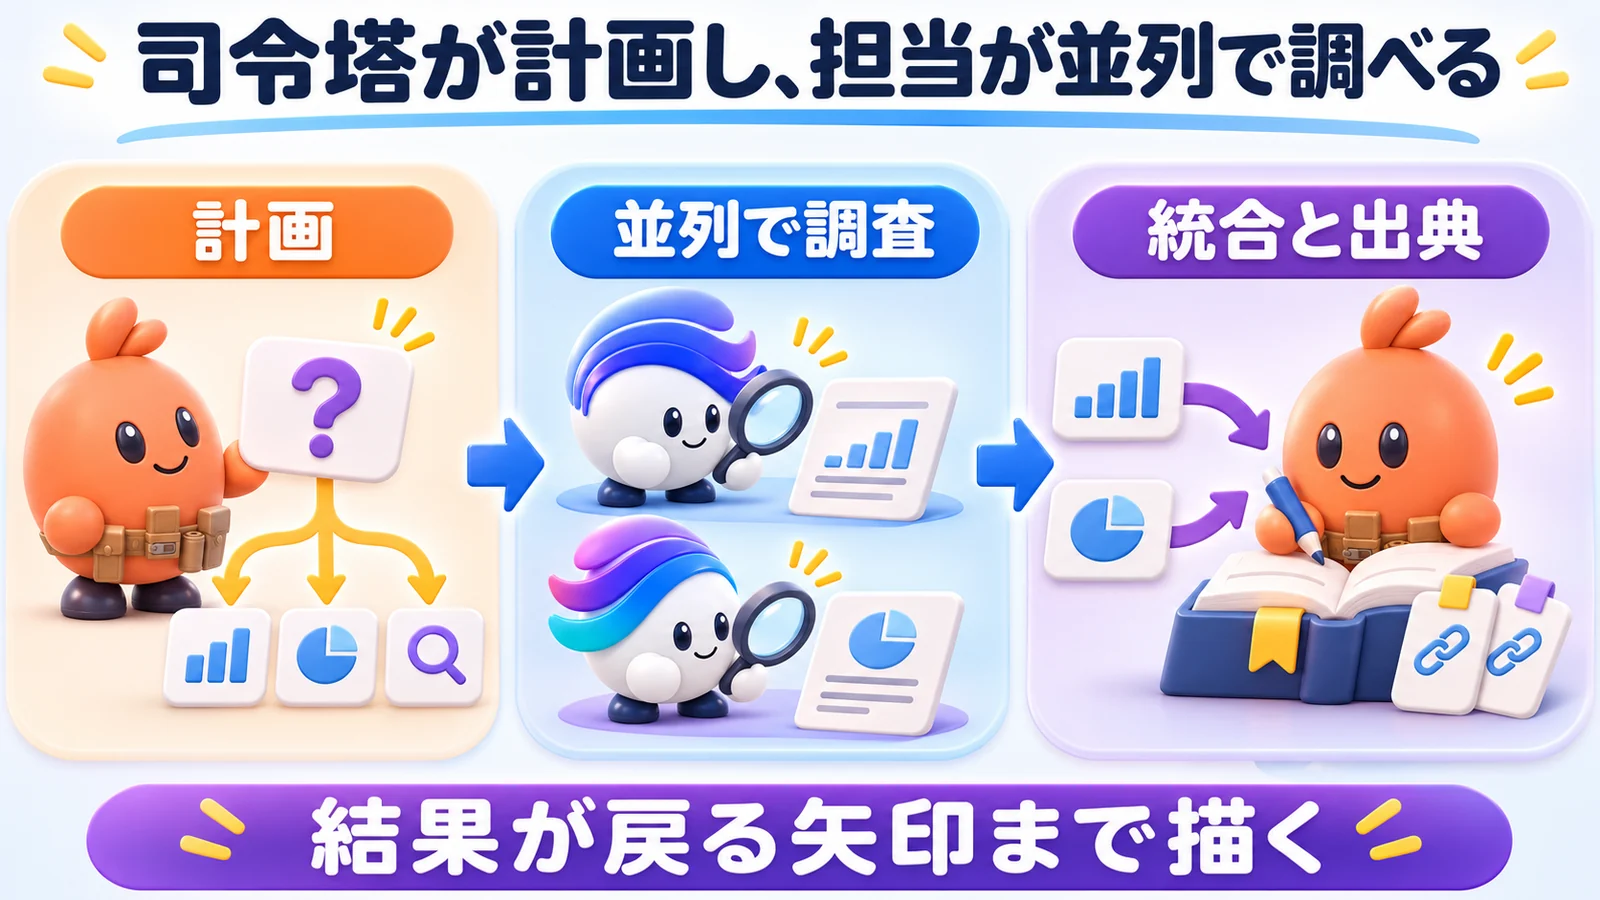
Anthropicの例では、司令塔が計画し、担当が別々に調べます。担当の出力を統合し、出典を付ける流れです。
司令塔は計画と点検
Anthropicの発表は、司令塔と担当の構成を示しています。司令塔が問いを分け、担当からの結果を受け取ります。出典を扱う係と記憶も、構成に含まれています。
Anthropicの公式図で、情報の流れを見る画面です。
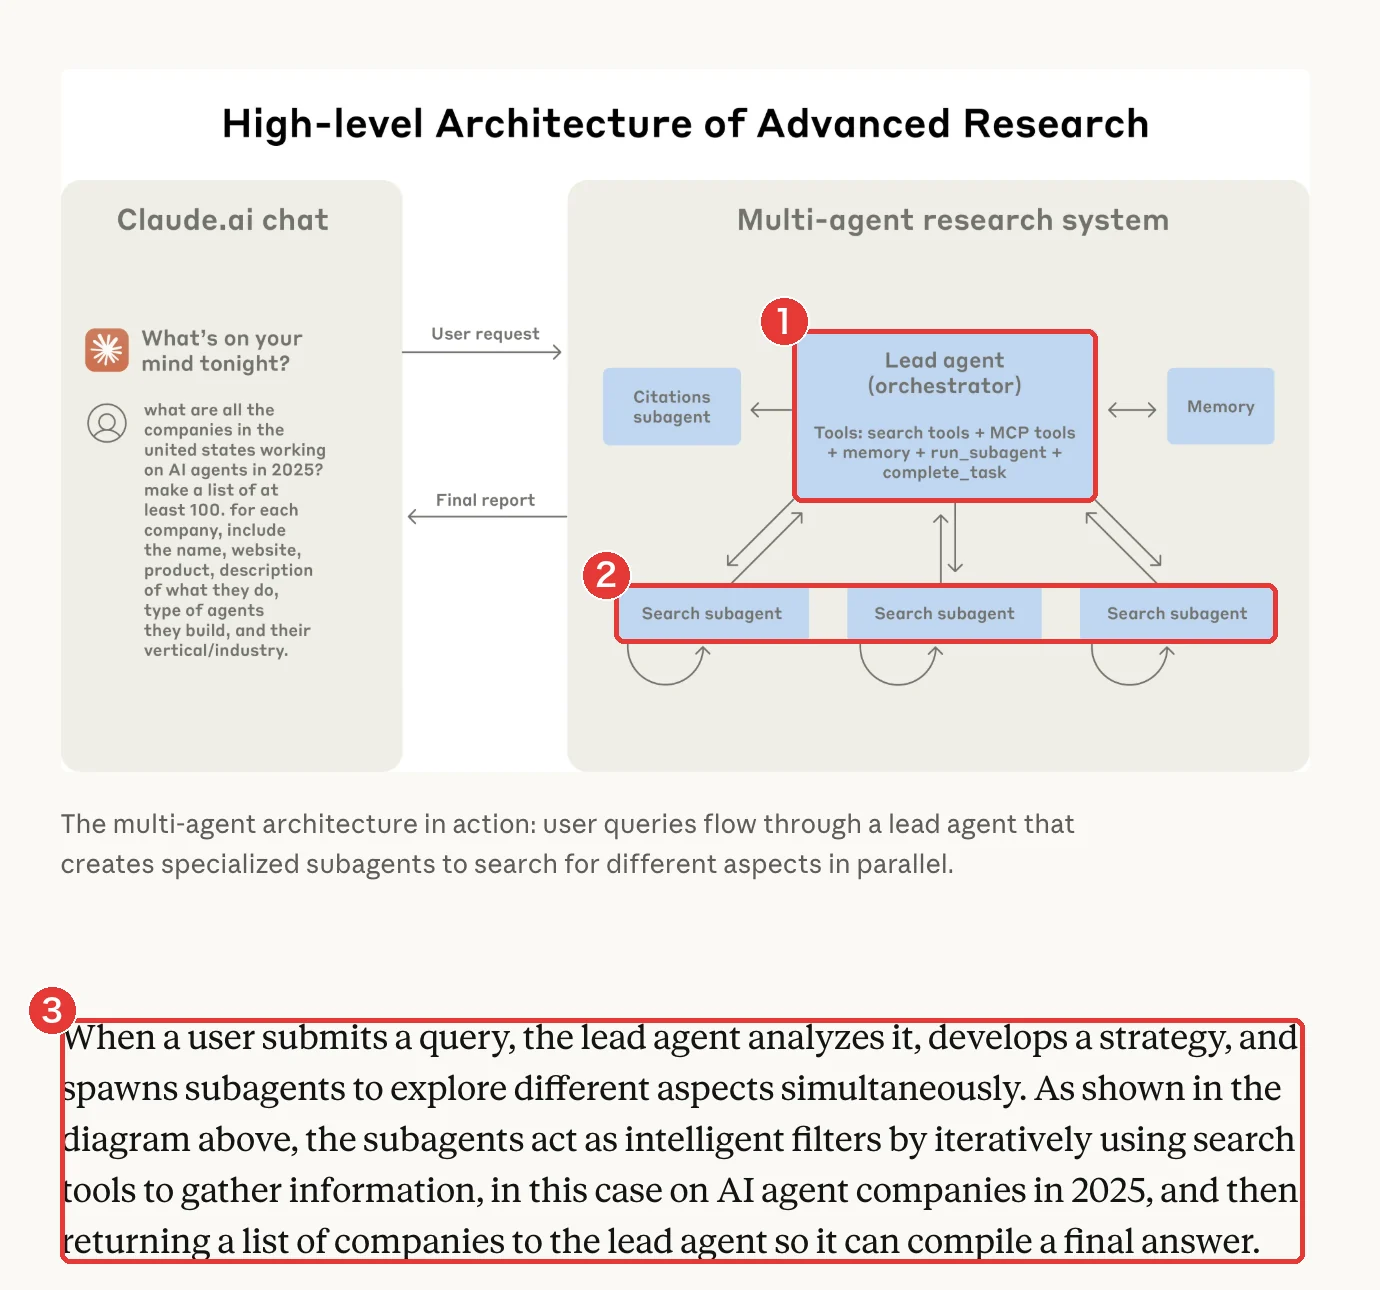
- 1司令塔(Lead agent/orchestrator):検索・MCP・記憶・担当の起動・完了の道具を持つ
- 2担当(Search subagent)3体:それぞれ別の側面を探して司令塔へ返す
- 3説明文:ユーザーの問いを司令塔が分析して戦略を立て、担当を起動して並行して調べさせ、集まった一覧から最終回答をまとめる
赤枠の司令塔と担当の矢印を追います。自社の分担図にも、依頼だけでなく結果が戻る矢印を書きます。
WEBMARKSも、統括に実作業をさせない判断を公開しました。計画する役と作る役を分ける考え方です。
担当は並列で調べる
Anthropicは、調査の時間を最大約90%短縮したと発表しています。社内評価では、単体を90.2%上回ったとしています。これらは同社の構成と評価での結果です。
Anthropicの数字を、そのまま自社の予測には使えません。担当を分けても、全員が同じ資料を待つなら並列になりません。独立して調べられる問いを見つけ、まとめる時間も確認します。
開発元Anthropicの公式アカウントは2026年10月、並列利用の研究を紹介しました。
投稿では、数千のClaudeを攻め役として使う研究を説明しています。通常業務で数千体が必要という意味ではなく、目的に沿って分担を考えます。
渡す4点
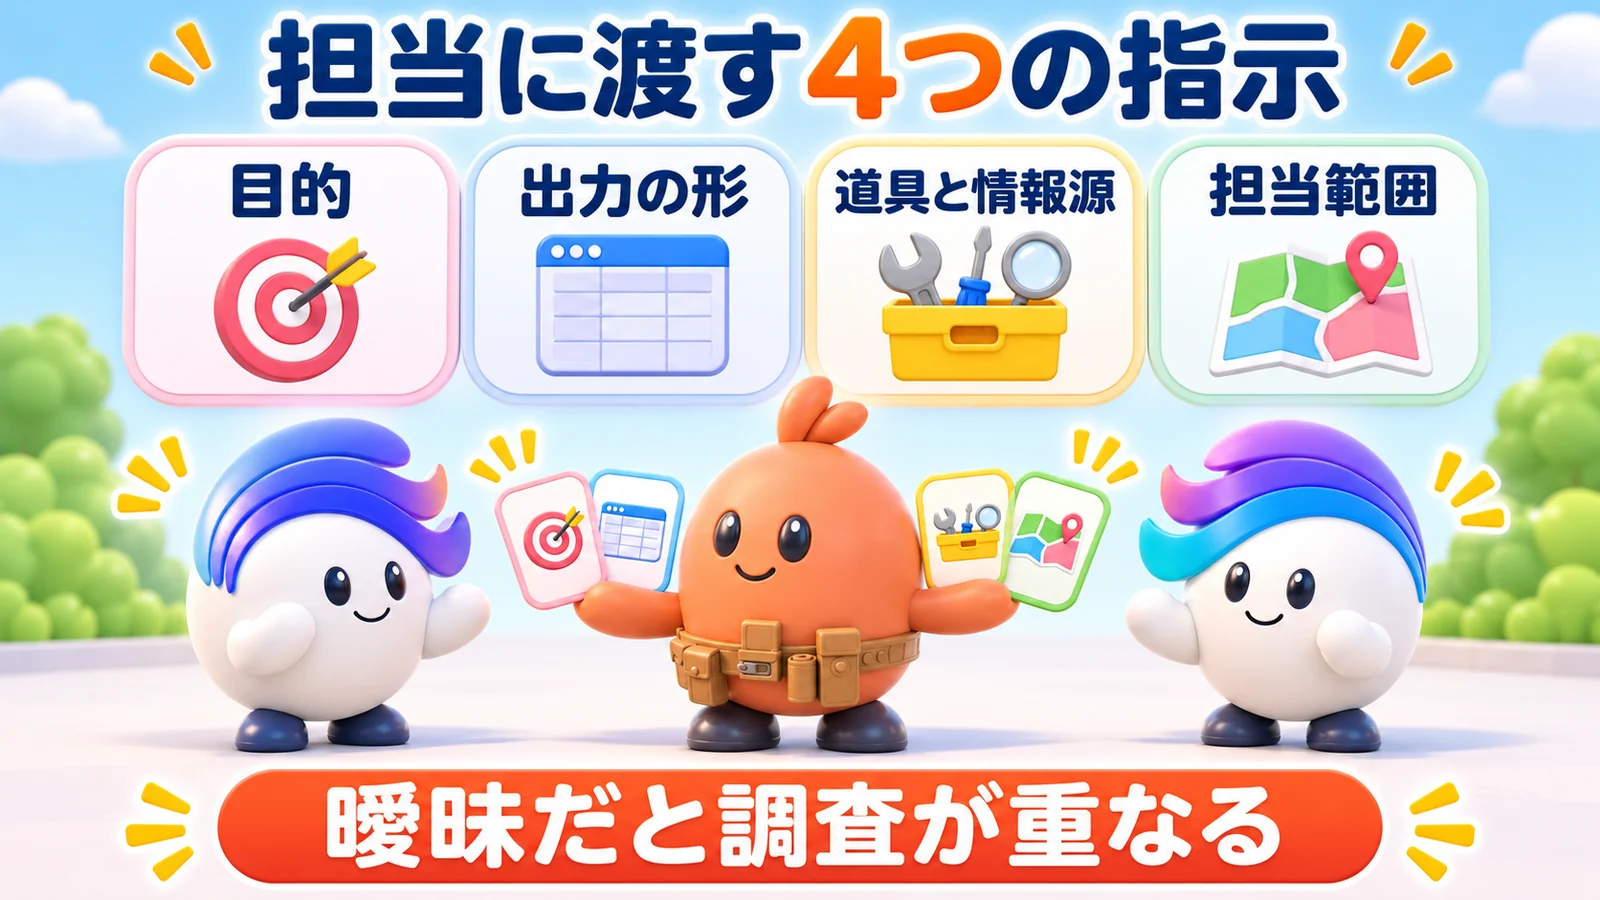
Anthropicは、担当への依頼が曖昧だと調査が重なると説明します。渡すのは目的、出力の形、道具と情報源、担当範囲です。担当範囲には、他の担当へ任せる部分も書きます。
Anthropicの説明を、候補の比較調査へ当てはめてみます。目的は「候補を紹介する」より「どの条件なら採用するか」が明確です。目的が曖昧なまま分けると、各担当が別の基準で調べます。
出力の形には、結論、根拠、分からなかった点を指定します。Anthropicの調査例でも、後で統合できる結果が必要です。文章だけで返させるより、比較項目を合わせて渡します。
道具と情報源は、使える物の一覧と優先順を決めます。OpenAIの受け渡しでも、次の担当へ何を渡すかが問題になります。資料を増やす前に、その担当が読む必要のある物を選びます。
担当範囲は、たとえば候補ごと、工程ごとに切り分けます。WEBMARKSの記事制作なら、担当フォルダの範囲が境界になります。別の担当の本文へ手を入れない条件も、依頼に含めます。
Anthropicが挙げる重複の問題は、出力を比べると発見できます。同じ資料を読む必要がある場合も、答える問いは分けます。統括は「誰が何を返すか」を見て、重複と抜けを点検します。
目的:どの問いに答えるか
出力の形:見出し、表、根拠の示し方
使う道具と情報源:許された資料と操作
担当範囲:扱う所と、触らない所
完了の条件:受取人が確認できる条件
効果的なエージェントの設計も、単純な構成から始める方針です。事前に分け方が決まらない仕事に、司令塔と担当が適します。停止条件と人の確認も、構成の一部として決めます。
マルチエージェントの設計パターンは?受け渡しと9つの型
関係を決めた次は、担当同士が仕事を渡す方法を決めます。OpenAIの受け渡しとGoogleの設計分類が参考になります。
受け渡し(handoff)
handoffは、受付が専門の窓口へ案内するような仕組みです。OpenAI Agents SDKでは、別の担当へ仕事を渡します。モデルからは、呼び出せる道具の一つとして見えます。
OpenAIの公式文書で、受け渡しの定義を読む画面です。
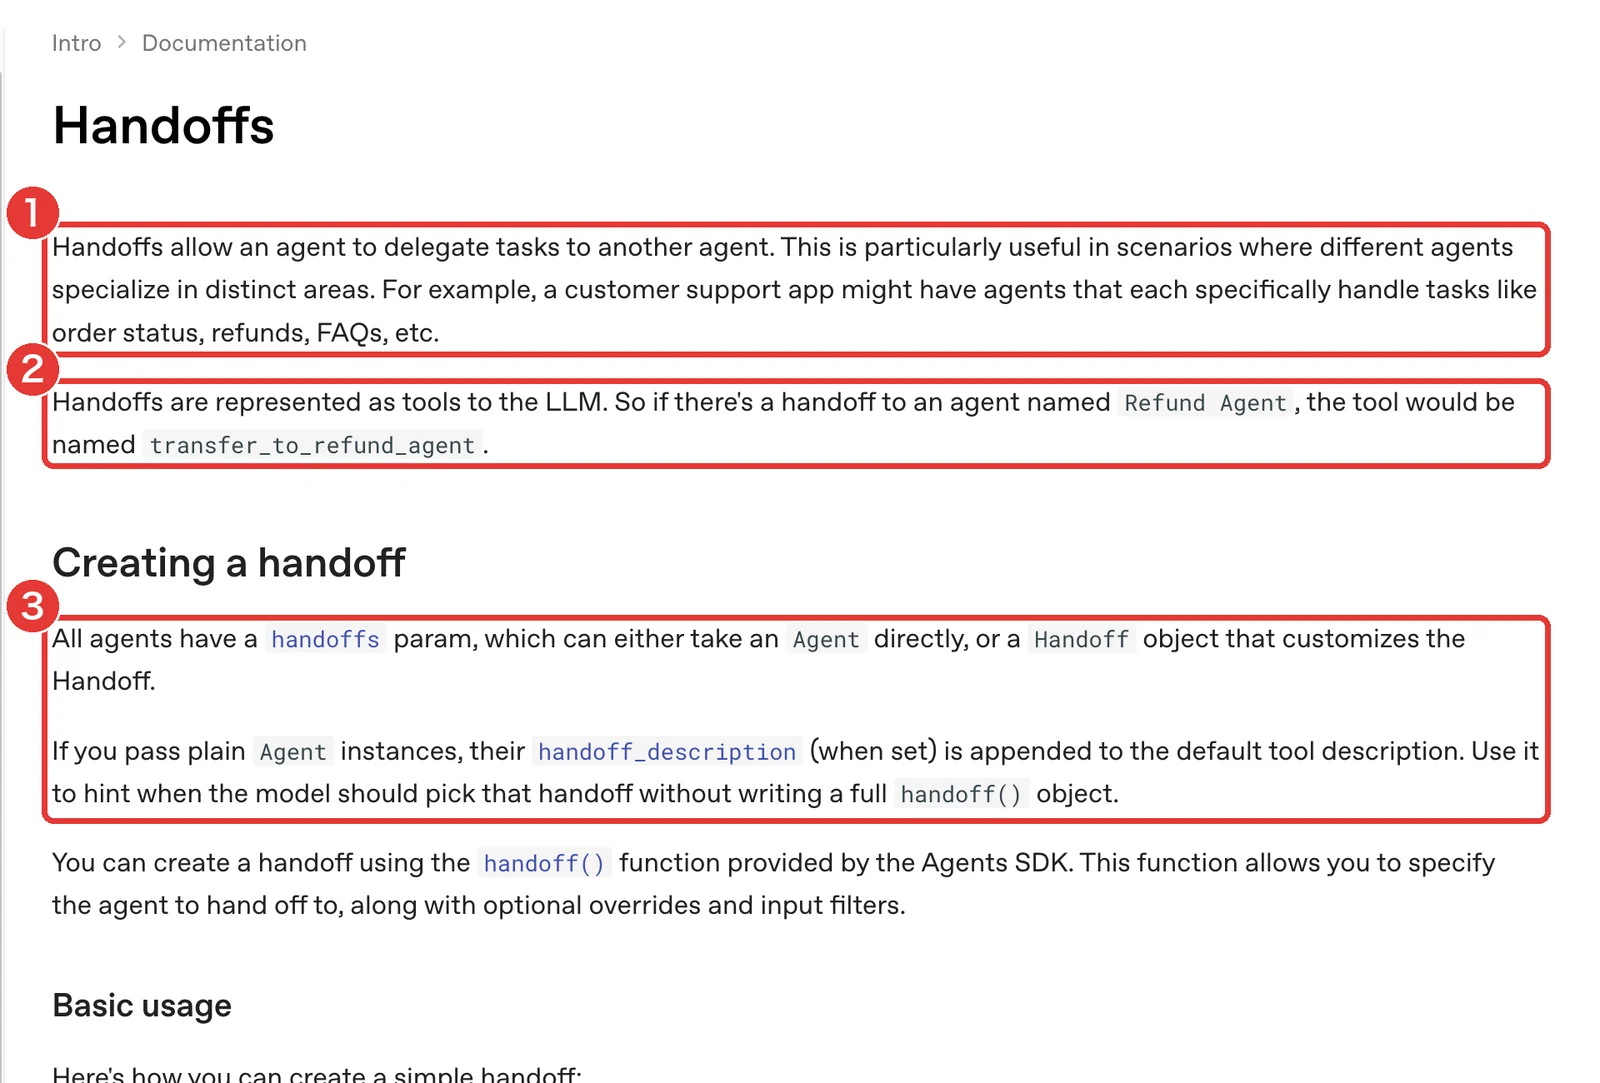
- 1受け渡し(Handoffs)=エージェントが別のエージェントへ仕事を任せる仕組み(注文状況・返金・FAQ のように担当分野を分ける例)
- 2受け渡しはモデルからは「道具」として見える(Refund Agent への受け渡しは transfer_to_refund_agent という道具名になる)
- 3エージェントの handoffs に渡し、handoff_description で「どんな時に選ぶか」のヒントを足す
赤枠1で定義、赤枠2で道具名、赤枠3で受け渡し先の説明を確かめます。呼び出す条件を、担当ごとに書き出します。
OpenAIの入力フィルターは、渡す履歴を絞る仕組みです。ただし、それだけで機密を完全に隠せるとは扱いません。渡してよいデータと実際の入力を、別に点検します。
9つのパターン
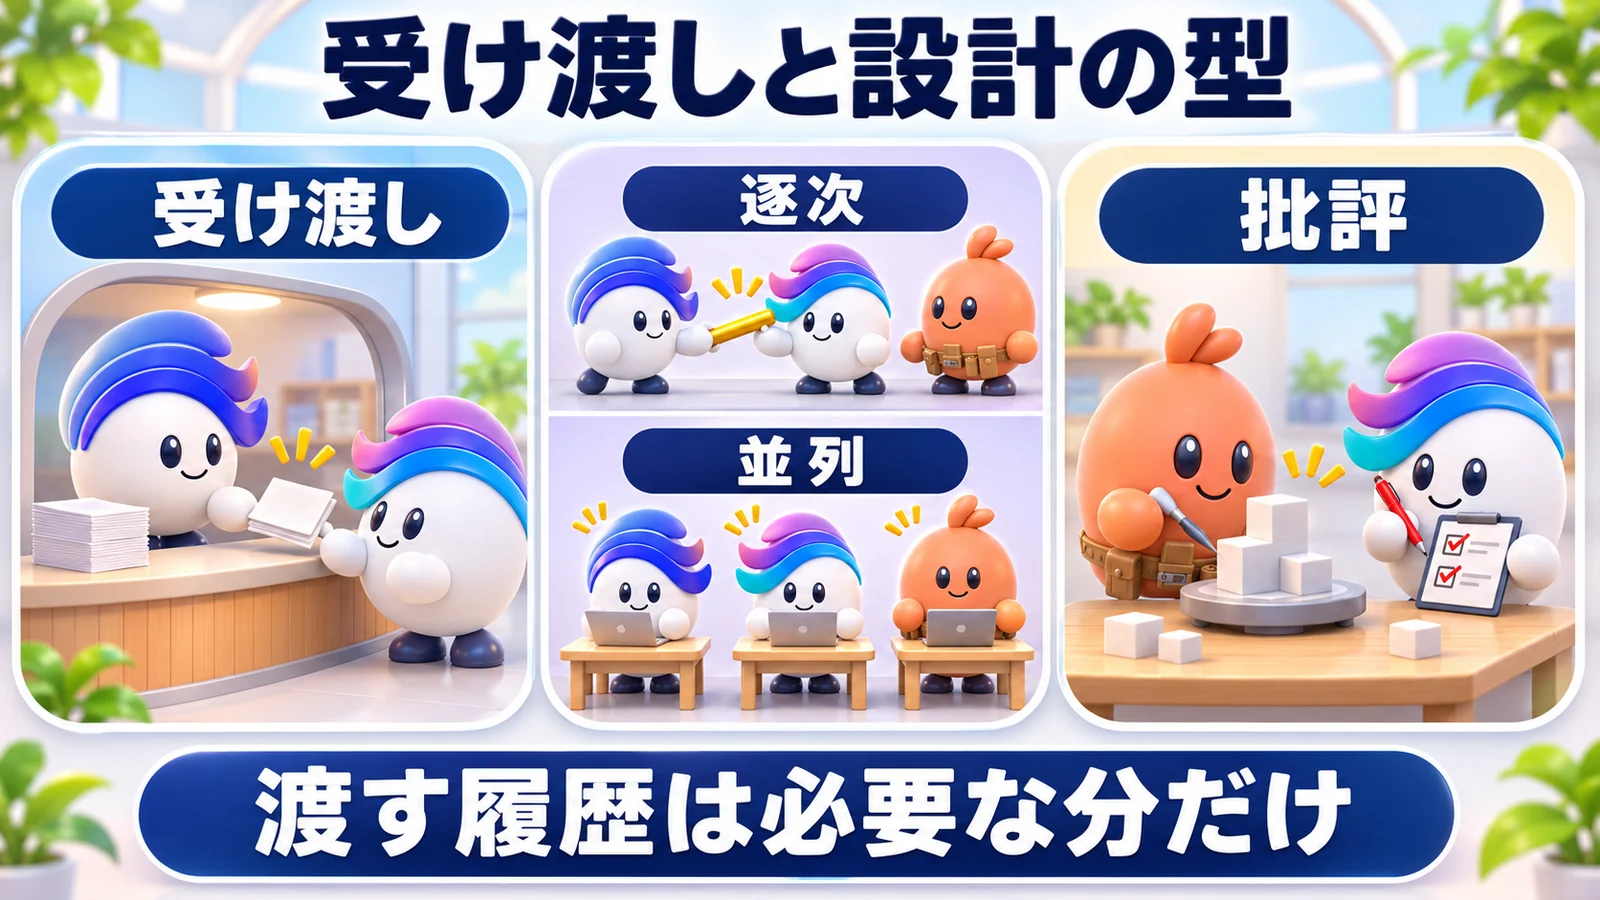
Google Cloudの設計ガイドは、九つの型を整理しています。型は、組み立て方を選ぶための見取り図です。目的が違えば、同じ道具でもつなぎ方を変えます。
- 逐次:前の結果を次へ渡します。
- 並列:分けた仕事を同時に進めます。
- ループ:条件に応じて繰り返します。
- 批評:作る係と批評する係を置きます。
- 反復的改善:結果を直す流れを作ります。
- コーディネーター:調整する係を置きます。
- 階層的分解:大きな仕事を段階で分けます。
- スウォーム:群れのように担当が連携します。
- カスタム:目的に応じた構成を作ります。
Google Cloudの公式ガイドで、設計パターンと安全の注意を読む画面です。
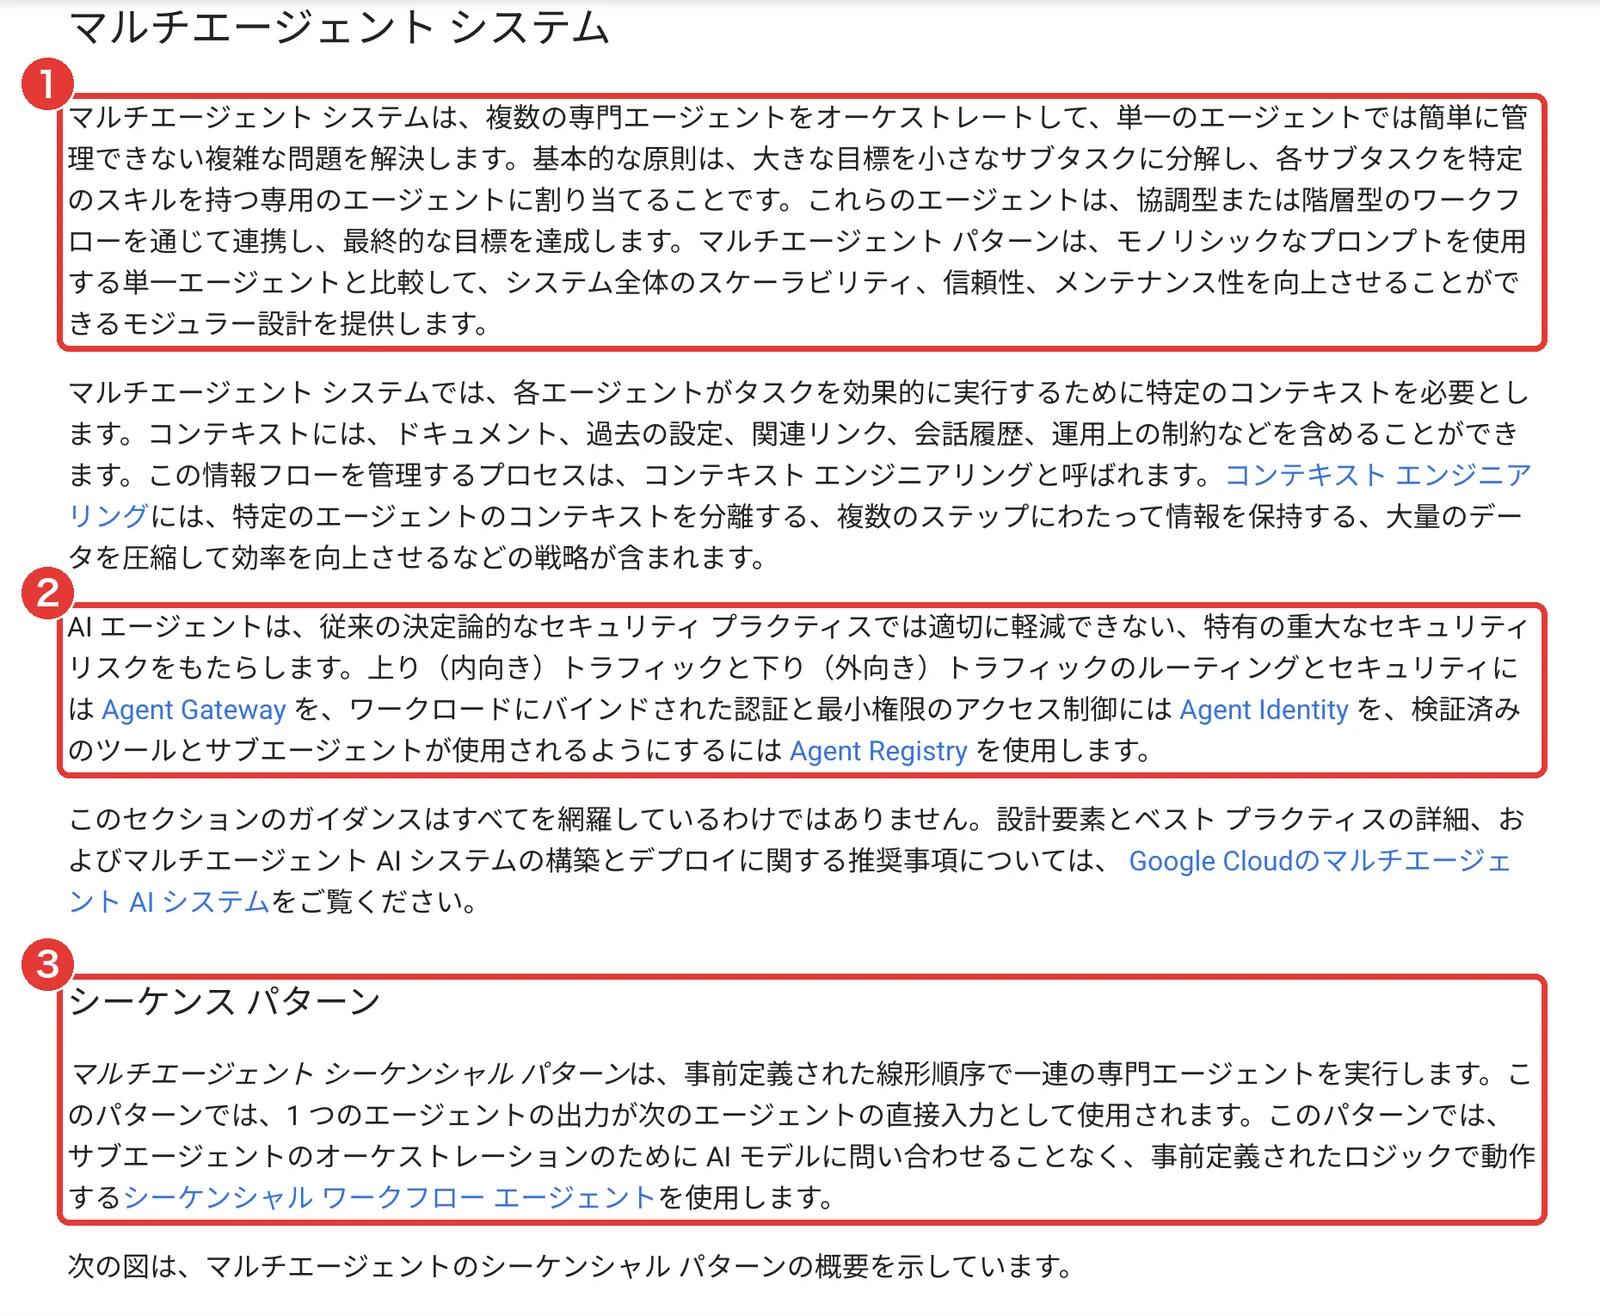
- 1マルチエージェントは複数の専門エージェントを束ね、大きな目標をサブタスクに分けて専門エージェントへ割り当てる(協調型か階層型の流れ)
- 2エージェントは従来の安全対策では軽減しにくいセキュリティリスクを持つ。最小権限のアクセス制御(Agent Identity)などを使う
- 3シーケンス パターン:決めた順に専門エージェントを実行し、前の出力を次の入力にする(ほかに並列・ループ・批評・コーディネーター・階層・スウォームなど)
赤枠1で分け方、赤枠2で最小権限、赤枠3で逐次の型を確かめます。画面は機械翻訳なので、型の名前は英語の原文とも照合します。
Googleの逐次型を選ぶなら、前の結果を待つ時間が生じます。調べが終わらなければ本文へ進めない、といった依存がある場合です。独立した調査を逐次にすると、待たなくてよい所まで待ちます。
一方で、Googleの並列型では、後から結果をそろえる必要があります。担当が全員違う形式を返せば、統合の手間が増えます。Anthropicの四点の指定を、ここでも先に渡します。
Googleの批評型では、作成と評価を分けます。たとえばWEBMARKSの記事では、本文を作る担当と採点する担当が違います。同じ基準を双方へ渡すことで、何を直すかを対応させます。
ループや反復的改善を使うなら、終わる条件も必要です。Anthropicも、停止条件と人の確認を設計に含めています。「よくなるまで」だけで頼まず、満たす条件と試す範囲を決めます。
Vercel Labsのエンジニアctatedevは2026年10月、PC操作の例を公開しました。
投稿のagent-desktopでは、各担当が自分のカーソルを持ちます。同時操作の例ですが、同じ対象を編集させる際は衝突を検討します。
つなぎ方の標準
NISTは、AIエージェントを相互につなぐ標準づくりを進めています。柱はつなぎ方の標準、オープンな規格、安全と本人確認の研究です。
MCPやA2Aは、つなぎ方を考えるときに出てくる規格名です。MCPは道具につなぐ共通の差し口と考えると分かります。A2Aは、担当同士が話すための共通の言葉にたとえられます。担当を増やす設計と、道具をつなぐ設計は分けて確認します。
マルチエージェントはいつ使う?使わない方がよい場面
Googleは、まず単一の担当から始めるよう勧めています。一つに責務が多すぎるとき、複数への分割を検討します。
向く仕事
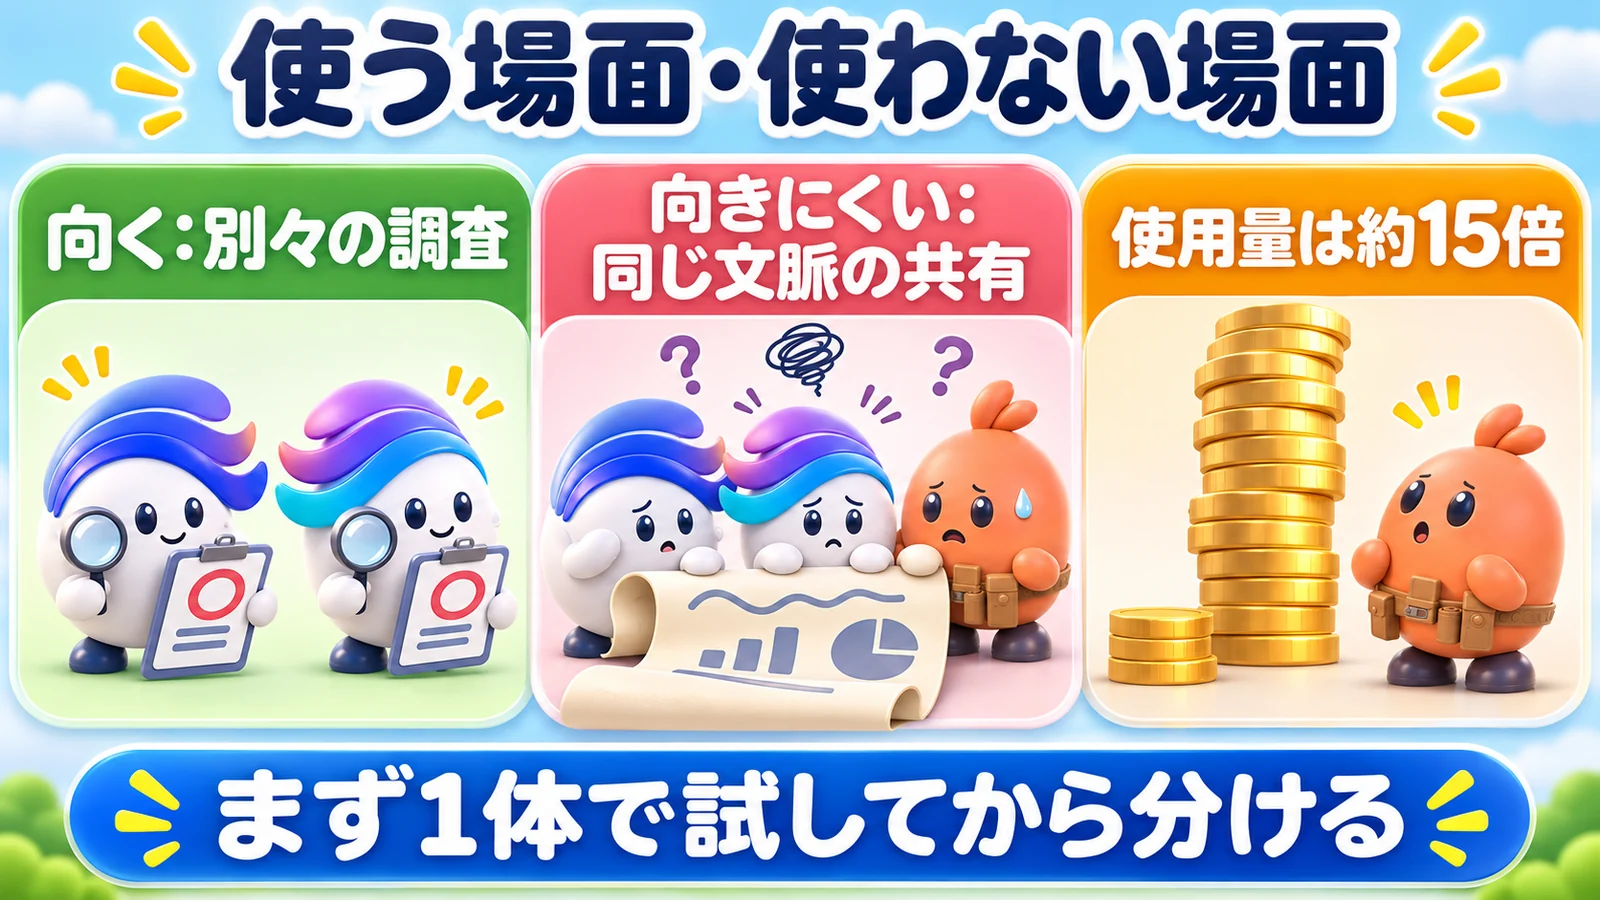
Anthropicの調査システムのように、独立した問いは分けやすい仕事です。たとえば異なる候補を調べ、共通の形式で結果を集める場合です。結果を比較する項目は、調査前にそろえます。
Googleの並列や批評の型も、担当の分け方を考える材料です。作る係と確かめる係では、同じ作業を繰り返す必要がありません。ただし、批評の結果を誰が直すかまで決めます。
向かない仕事
Anthropicは、全員が同じ文脈を必要とする仕事の難しさを挙げます。文脈とは、会議の前提や途中の判断を含む話の流れです。各担当へ同じ説明を何度も渡すと、連絡の負担が増えます。
| 場面 | 向く・向かない | 理由 |
|---|---|---|
| 別々の候補を調べる | 向く | 問いを独立させやすい |
| 作成と批評を分ける | 条件つきで向く | 判定の基準が必要 |
| 全員が同じ文脈を使う | 向きにくい | 共有の負担が大きい |
| 小さな一問へ答える | 増やす前に検討 | 分担の負担が勝ちやすい |
費用
Anthropicのデータでは、単体でもチャットの約4倍を使います。複数の担当では、約15倍のトークンを使うと説明しています。トークンは、AIが読む量と書く量を数える単位です。
Anthropicの使用量と評価の説明を読む画面です。
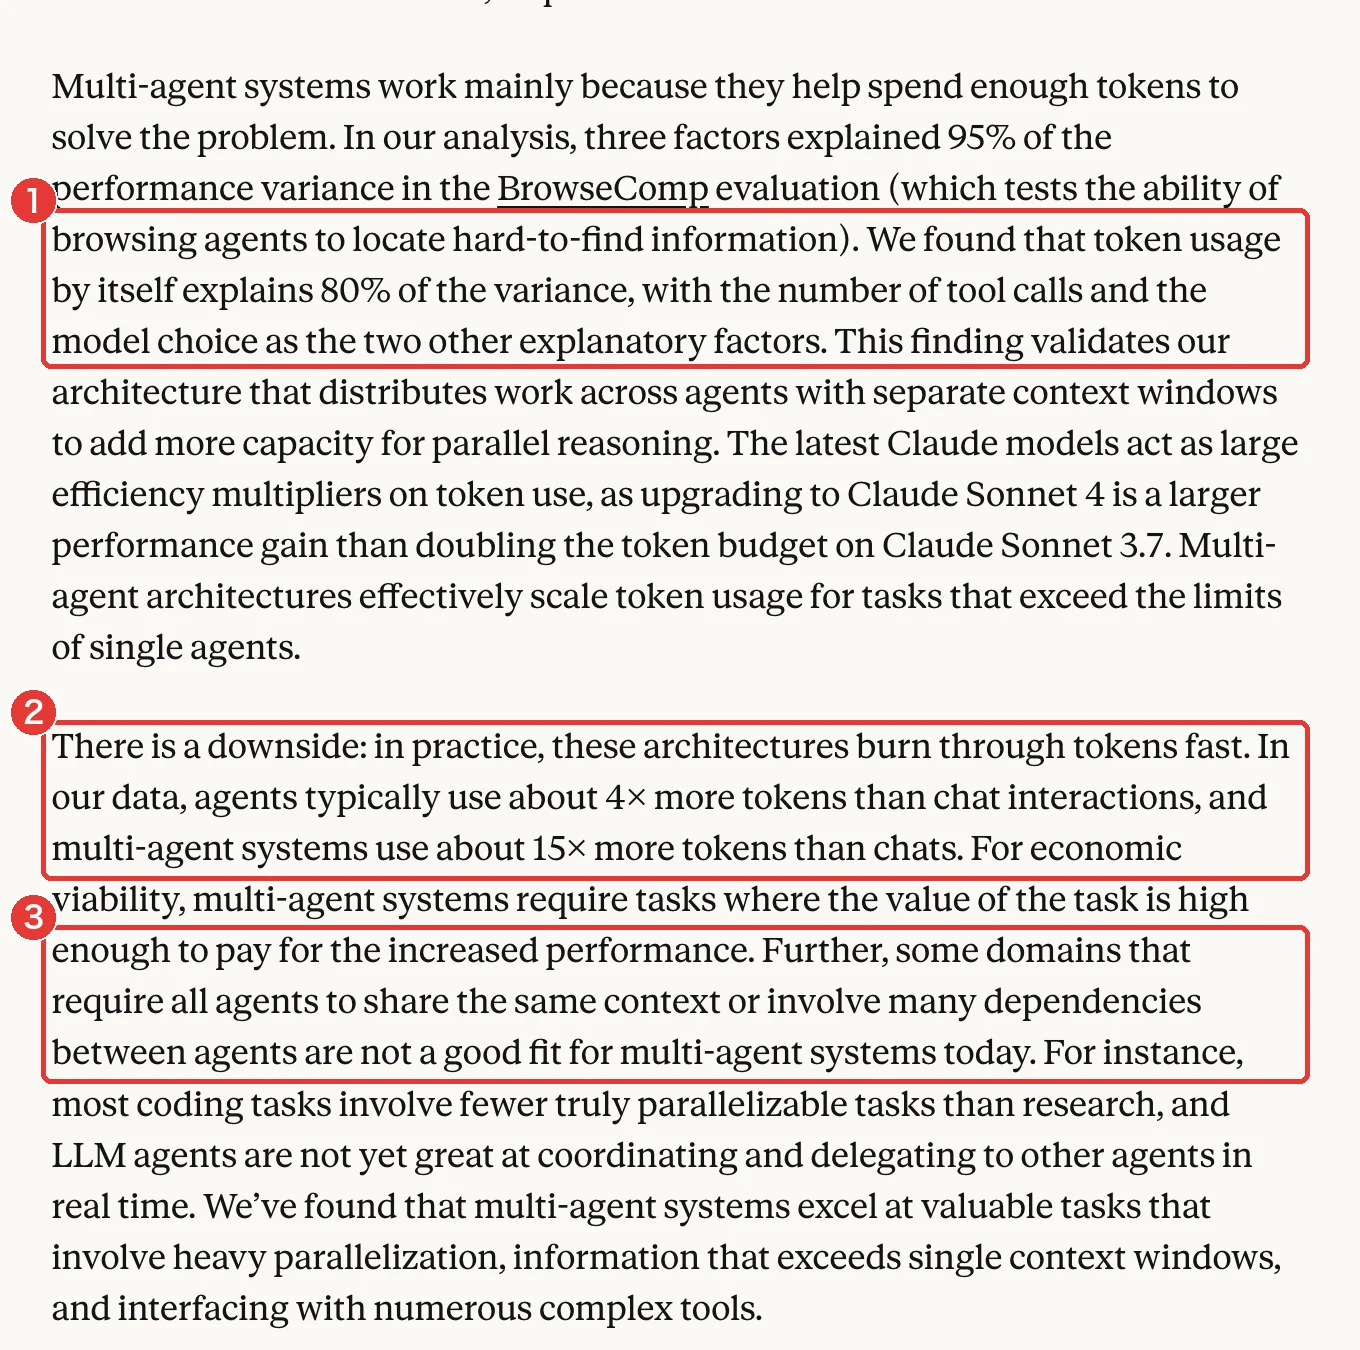
- 1評価(BrowseComp)での分析:性能の差の約80%はトークンの使用量で説明できる
- 2エージェントはチャットの約4倍、複数体は約15倍のトークンを使う。割に合うのは価値の高い仕事
- 3全員が同じ文脈を要する仕事や、担当同士の依存が多い仕事は、今のところ複数体に向かない
赤枠で、約4倍と約15倍の比較対象を照らします。金額へそのまま置き換えず、自社で必要な処理量を測ります。
Anthropicの分析では、性能差の約80%を使用量で説明しました。これは同社の分析の結果で、担当数だけの効果ではありません。分担そのものと、使った量を分けて考えます。
Anthropicの約15倍は、同社の調査システムの説明です。全員が同じ長い資料を読む場合も、使用量は積み上がります。担当へ全文を配る必要があるか、出力の要約で足りるかを検討します。
Googleの「単一から始める」方針は、比較の基準にもなります。最初に単体での結果を残せば、分割後の変化を照らせます。出来上がった物の質と、まとめる負担も同じ条件で比較します。
Microsoftが論じる人とAIの比率も、費用と別に見る必要があります。AIが安く動いても、人の確認待ちが増えれば仕事は進みません。採点や承認を受け取る人が、どの結果を判断するか決めます。
Claude Codeの開発に関わるBoris Chernyは2026年10月、使用量を説明しました。
投稿では、サブエージェントが親の努力度を引き継ぐ点を挙げています。Agent Teamsの費用も積み上がるため、/usageで内訳を確認します。
反対意見
Devinを開発するCognitionは、複数体の構成に反対する立場も示しています。長く動く本番では、担当間の情報共有が脆さにつながるという見方です。Anthropicの成功例と併せて、仕事の違いで読み分けます。
MicrosoftのWork Trend Indexは、人とAIの比率を論じています。担当が増えても、人の判断が追いつかなければ仕事は滞ります。確認する人の量も、増やす前に考えます。
増やしすぎ
WEBMARKSは、30人中27人が呼ばれなかった経験を公開しています。役割を並べることと、実際に仕事が届くことは別です。自社の担当図でも、最後に何を受け取ったかを確認します。
マルチエージェントの危険は?権限の連鎖と守り方
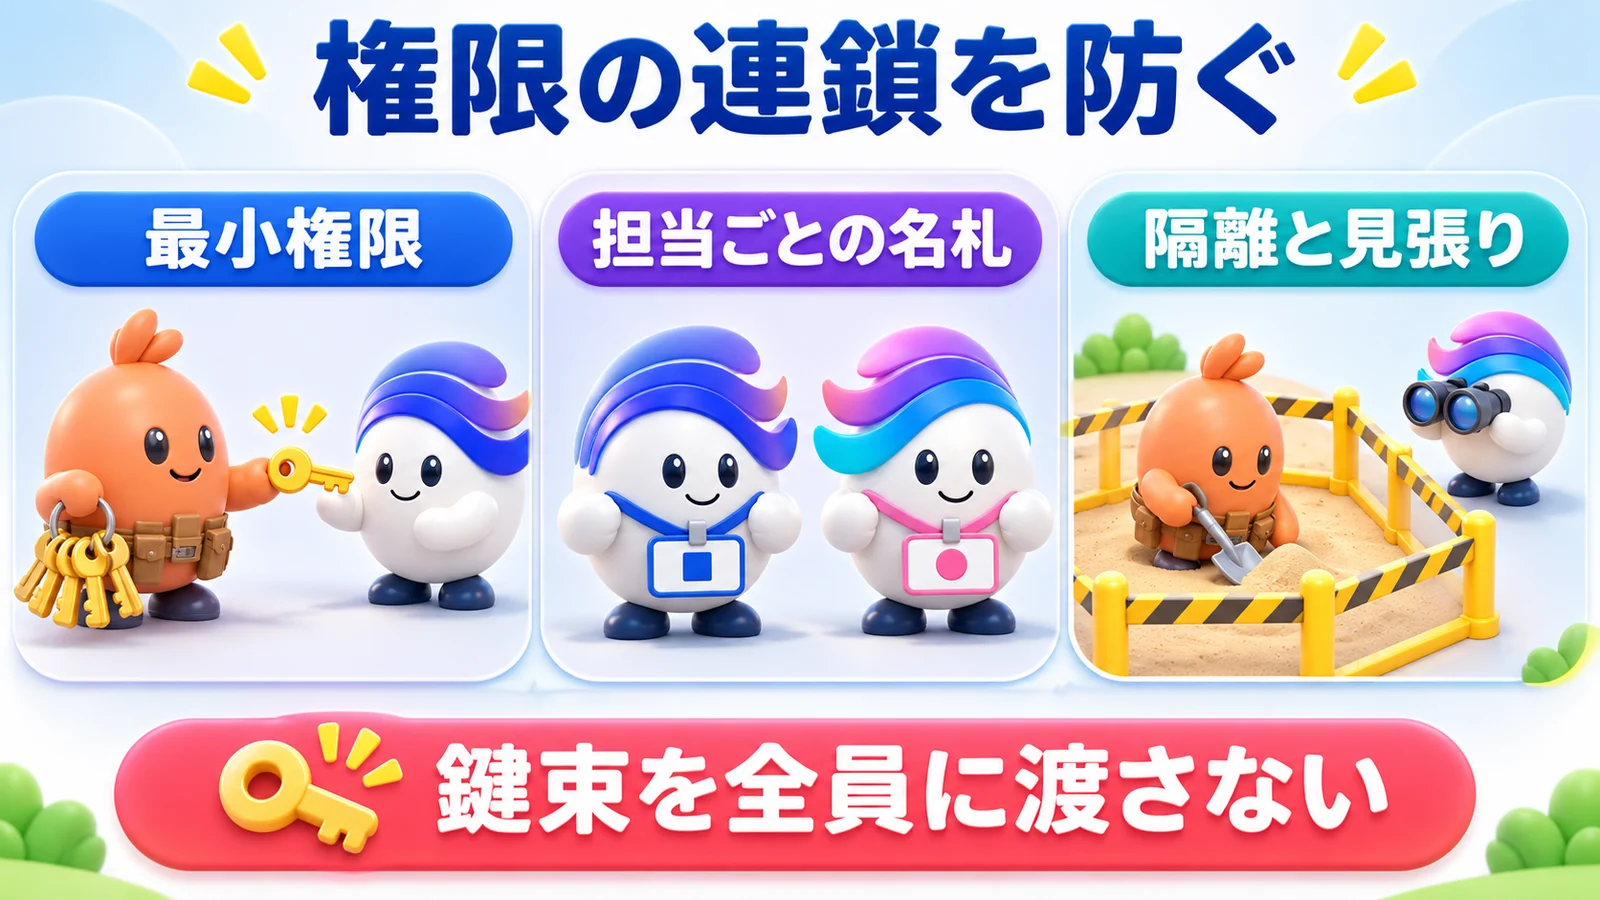
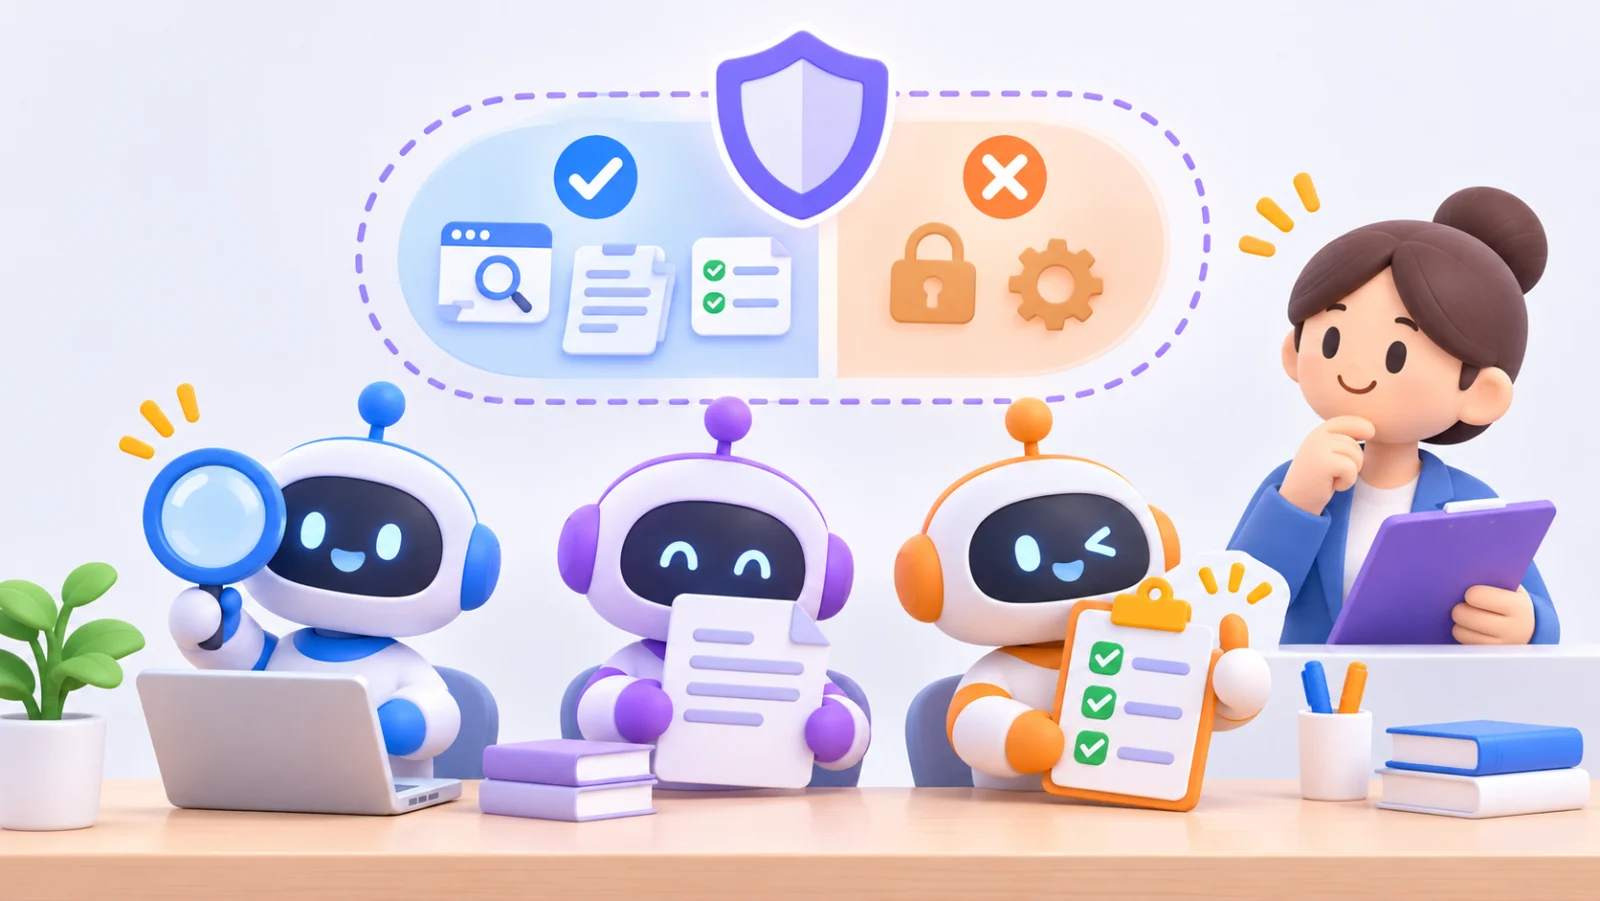
IPAは、上位の権限が下位へ引き継がれる問題を挙げています。担当ごとに必要最小限の権限を渡す設計が要ります。
権限が下へ引き継がれる
権限は、開ける部屋を決める鍵束に似ています。IPAの手引書63ページは、権限の連鎖を説明しています。上位の全権限を下位が使えると、不要な操作まで可能になります。
IPAの説明するConfused Deputyは、権限を持つ代理人の問題です。本人には許されない操作を、強い代理人に行わせるような構図です。複数体では、どの担当が何を許されるかを確認します。
IPAの64ページは、担当ごとの固有IDによる記録も挙げています。固有IDは、同じ制服の担当にも名札を付ける考え方です。誰が入力を受け、どの道具を使ったかを区別します。
IPAの最小権限を調査の担当へ当てはめると、読む範囲を絞ります。資料を調べる係に、公開や送信まで任せる必要はありません。司令塔ができることと、担当ができることを別々に記します。
OpenAIの履歴フィルターと、IPAの権限制限も別の対策です。見せる情報を絞ることと、実行できる操作を絞ることは違います。どちらかを設定しただけで、もう片方も済んだとは扱いません。
IPAの固有IDによる記録は、事故の後の調査にも関わります。結果が誤っていた場合、どの担当の入力から変わったかを追います。最終回答だけを残すより、受け渡しの経路を区別します。
記憶の汚染と侵入
総務省の検討会資料は、誤情報による記憶の汚染も挙げています。ある担当の間違いが、共有した記憶を通して広がる問題です。同じ答えを複数の担当が返しても、根拠が独立とは限りません。
同資料では、悪意あるAIの侵入もリスクに含めています。相手の出力を、そのまま自分への命令として扱わない設計が要ります。出典、依頼元、権限の確認を別々に行います。
隔離と見張り
AI研究者Andrew Ngは2026年9月、隔離と見張りの不具合へ言及しました。
投稿は、エージェントの群れをめぐる件の原因を論じています。大量に並列化する前に、隔離と監視が機能するかを点検します。
隔離は、遊べる場所を囲った砂場のような考え方です。IPAの最小権限と組み合わせ、操作できる範囲を狭めます。監視では、担当別の記録と、停止する条件を確認します。
Claude Codeでマルチエージェントを試すには?
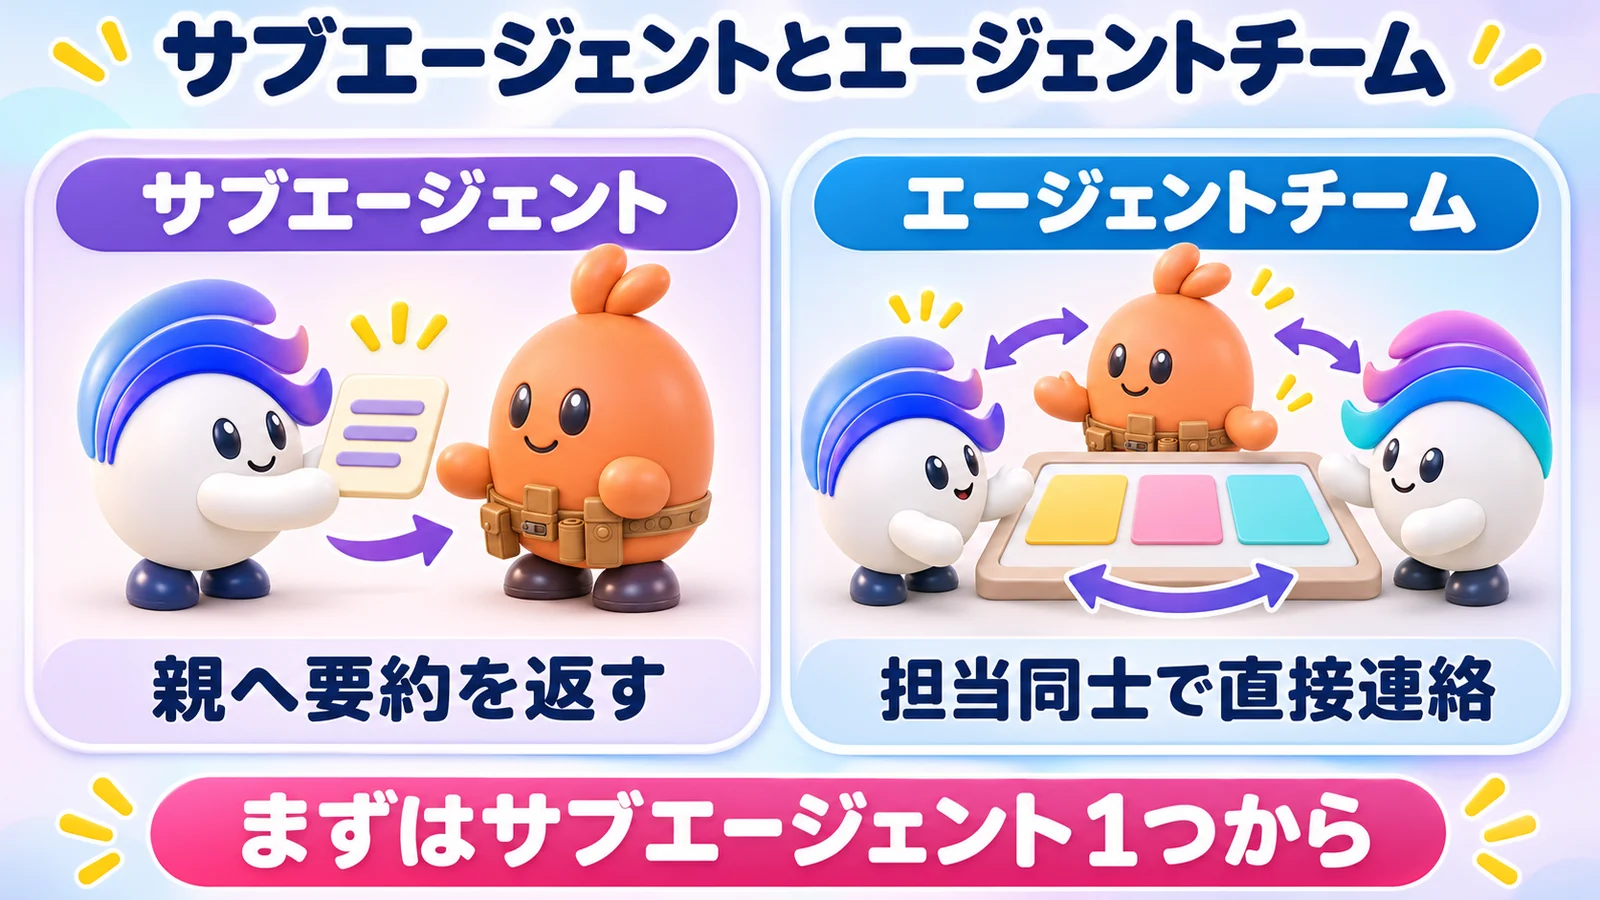
Claude Codeには、サブエージェントとエージェントチームがあります。結果の返し方と、担当同士の連絡方法が違います。
サブエージェント
公式のサブエージェント文書では、独自の文脈を持つ担当を説明します。道具と権限も担当に応じて設定します。親へは結果を要約して返す構成です。
サブエージェントは、調査結果だけを受け取りたい場合に検討できます。親の会話へ調査の全過程を戻さず、必要な結果を集めます。ただし、出典や判断の理由まで落とさない出力指定が要ります。
エージェントチーム
公式のエージェントチーム文書は、担当同士の直接連絡を説明しています。共有のタスクリストを使い、リーダーが調整します。親への結果返却だけでは足りない仕事で検討します。
エージェントチームは実験的機能で、既定では無効です。公式は、3〜5人から始める目安を示しています。班の中にさらに班を作るネストはできません。再開にも制約があります。
選び方
Claude Codeの公式比較で、二つの違いを読む画面です。
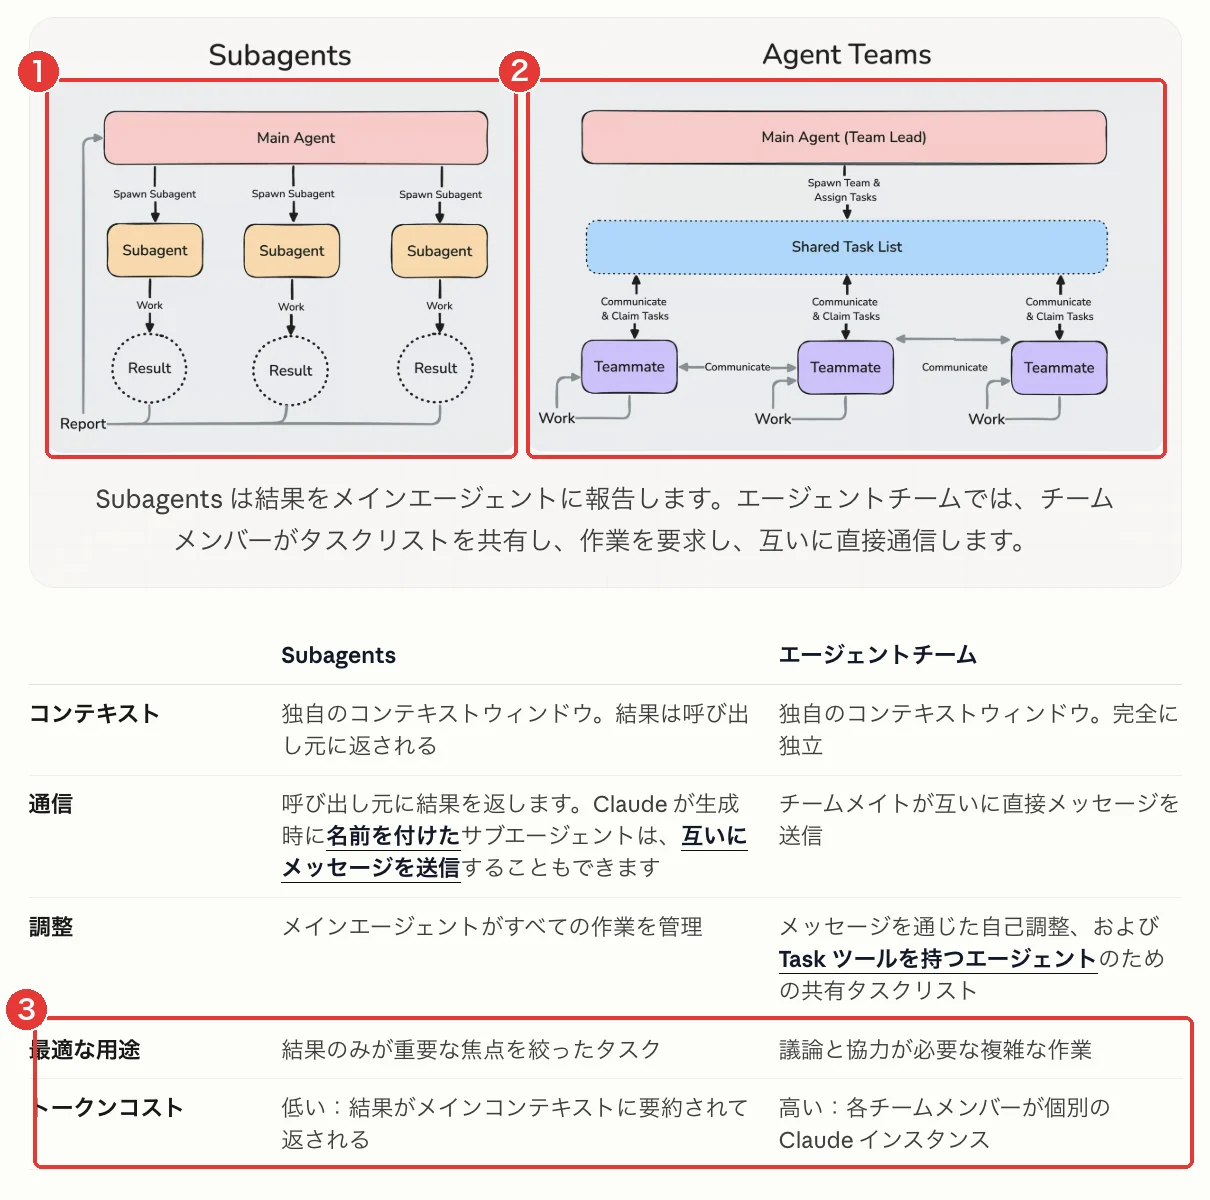
- 1Subagents:メインのエージェントが担当を生成し、担当は作業して結果をメインへ報告する
- 2Agent Teams:リーダーが共有のタスクリストで調整し、チームメイトが互いに直接通信する
- 3最適な用途とトークンコスト:Subagents は結果だけが重要な絞ったタスクで費用は低い/チームは議論と協力が要る複雑な作業で費用が高い
赤枠の連絡方法とタスクの持ち方を照らします。結果だけを返せばよいか、担当同士の直接相談が要るかで選びます。
| 項目 | サブエージェント | エージェントチーム |
|---|---|---|
| 結果 | 親へ要約を返す | チームで連絡する |
| 横の相談 | 親を経由する | 直接の連絡が可能 |
| タスク | 親が受け持つ | 共有リストを使う |
| 使用量 | 比較的低い | 高い(大幅に増える) |
| 提供の状態 | 通常の機能 | 実験的・既定は無効 |
Claude Codeの人数の目安は、全製品に共通の正解ではありません。Googleの方針どおり、まず一つで足りるかを試します。増やすなら、増やした理由と受け取る結果を残します。
Claude Codeのサブエージェントでは、親が結果を受け取ります。別々の候補を調べ、親が比較する形なら、この関係を検討します。担当同士が直接相談する必要まであるかを先に問い直します。
チームでの共有タスクリストは、仕事の状況をそろえるための物です。ただし、リストがあるだけで編集の衝突を防げるとは限りません。WEBMARKSの役割分担線と同じく、担当する対象も分けます。
公式文書にある再開の制約は、長い仕事で考慮する点です。再開すれば全員が同じ状態へ戻る、と決めつけません。途中で得た結果と次の担当への条件を、受け渡せる形で残します。
WEBMARKSのマルチエージェントの実例:社長から担当AIまで
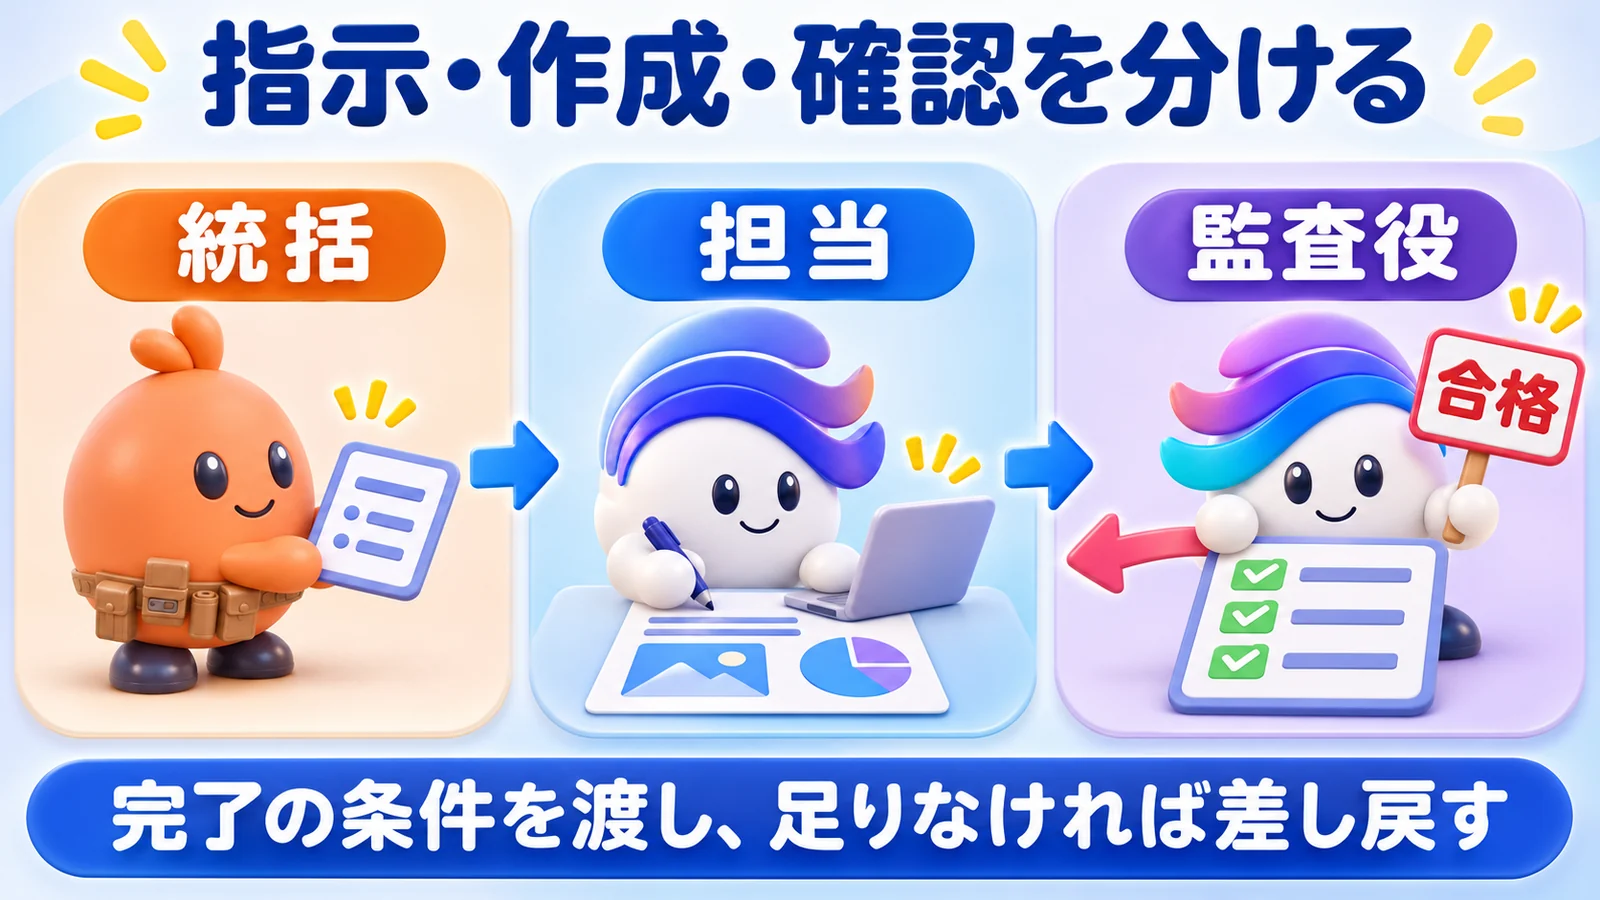
WEBMARKSでは、統括、担当、監査役を分けて記事を作ります。完了の条件を渡し、足りない物は差し戻す仕組みです。
指示の系統
公開の判断は代表の鈴木が持ちます。統括AIのClaudeは、全体の指示と見本の確認を行います。部署の工程を通し、担当AIへ作業を渡します。
今回の記事では、Xの最新投稿を探すGrokと下調べのAIが調べます。設計はClaudeのAPIです。本文は11月4日からOpenAIのCodexが担当します。APIは、外からAIを呼び出す受付のような仕組みです。
図解は、キャラクターの原版を渡したGPT Imageが担当します。点検は機械と、書き手とは別の会社のAIが受け持ちます。これらの役割分担と、個々の成果物が合格かは分けて確かめます。
受け持ちの線引き
WEBMARKSの指示書で、目的と担当の範囲を見る画面です。
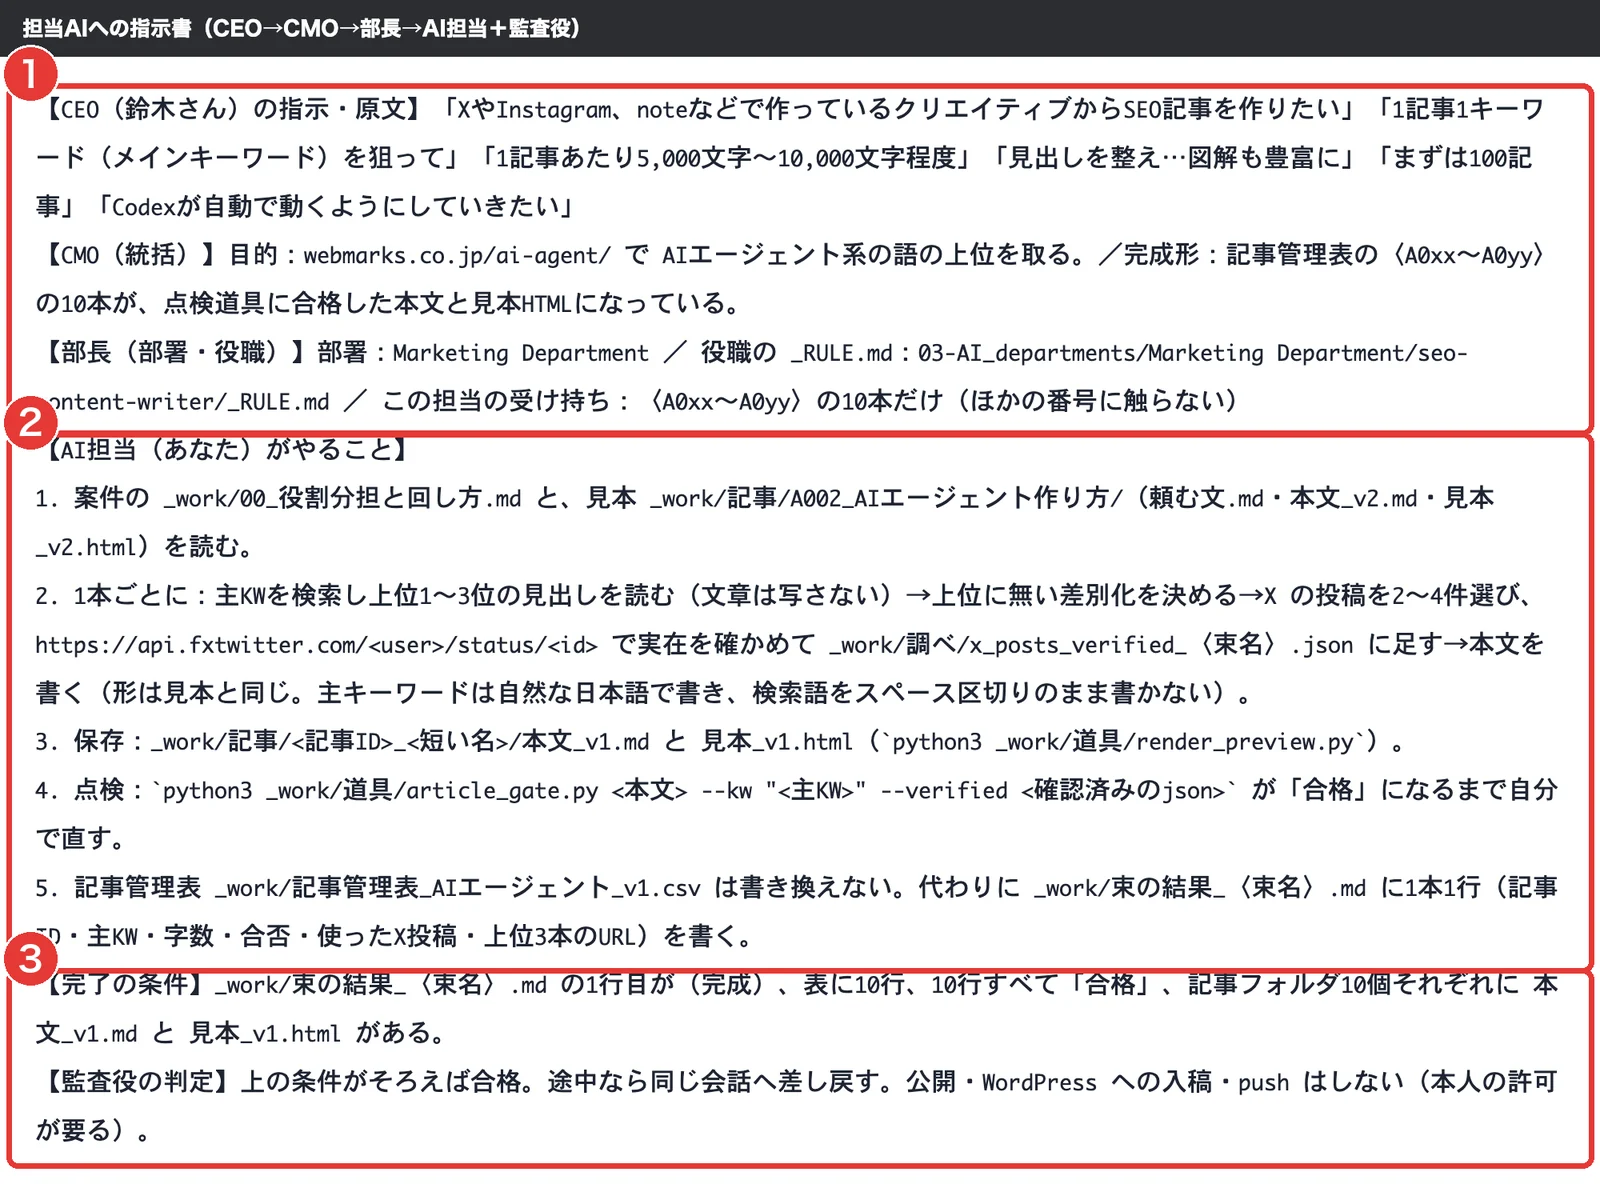
- 1指示の系統:社長(CEO)の指示→統括(CMO)の目的と完成形→部長の部署と受け持ち
- 2担当AI(あなた)がやること5つ。受け持ちは「〈A0xx〜A0yy〉の10本だけ(ほかの番号に触らない)」と範囲で区切る
- 3完了の条件と監査役の判定(条件がそろえば合格・途中なら差し戻し・公開や入稿はしない)
赤枠で、目的、受け持つ範囲、完了の条件を照らします。自社でも担当する対象を番号や保存先で分け、他の担当と重ねません。
並行作業の役割分担線でも、担当の境界を公開しています。同じ成果物を同時に直すなら、後の保存で上書きする危険があります。担当範囲と受入役を、着手前に決めます。
完了の条件と差し戻し
WEBMARKSは、否定を担当する別人格の設置も公開しています。作成者の自己評価だけで終えず、別の視点で問い直すためです。監査役には、条件ごとの証拠を確認させます。
WEBMARKSの指示書は、作業範囲だけでなく禁止する操作も示します。本文制作の担当へ、公開の判断まで渡す必要はありません。IPAの最小権限と同じく、必要な操作を工程ごとに絞ります。
監査役への依頼
完了の条件を一つずつ照らす。
各条件について、成果物の場所と根拠を示す。
合格か差し戻しかを判定する。
差し戻す場合は、場所・理由・直す内容を書く。
公開と入稿は行わない。
点検は機械の点検と、書き手とは別の会社のAIの採点です。85点未満は差し戻し、担当が指摘を直します。
組織としての分担はAI社員でも解説します。
マルチエージェントのよくある質問
Q. マルチエージェントとエージェンティックAIは同じですか?
完全に同じ言葉ではありません。国の脚注18は、複数のAIが自律して動く仕組みを説明します。その用語がエージェンティックAIです。マルチエージェントは、複数体の分担の形を指して使われます。
Q. 何体から始めればよいですか?
Googleは、まず単一から始めるよう勧めています。Claude Codeのチームでは、公式に3〜5人という目安があります。製品の目安を一律に使わず、独立した仕事の数で考えます。
Q. 費用はどれくらい増えますか?
Anthropicの研究例では、チャットの約15倍のトークンを使います。すべての製品で同じ金額になるという数字ではありません。自社では、担当だけでなく統合と点検の使用量も集計します。
Q. Claude Codeのエージェントチームはすぐ使えますか?
公式文書では実験的機能で、既定は無効です。担当同士の連絡や共有タスクリストを使う構成です。サブエージェントとの違いを先に照らして選びます。
Q. 担当に渡す会話の履歴は隠せますか?
OpenAI Agents SDKには、入力フィルターがあります。渡す履歴を絞れますが、機密の完全な隠しとは扱いません。必要な情報だけを渡し、実際の入力を確認します。
まとめ:マルチエージェントは1体から始めて分ける
マルチエージェントは、仕事を分けるための設計です。Anthropicの研究例は効果と使用量の増加を示しています。GoogleやCognitionの見方も照らし、増やす理由を決めます。
- 今の仕事を1体で動かし、収まらない所を書き出します。
- 分ける担当ごとに、目的と出力を紙にします。
- IPAの考え方に沿って権限を絞り、監査役か人の確認を置きます。
同志社大学を卒業後、設備メーカーの海外営業を経て2016年に独立。旅行・医療などのメディアを自ら運営し、SEOとWeb広告で検索上位を数多く獲得してきました。いまはWebマーケティングのスクールと法人研修を運営しながら、11部署57名のAIエージェントと会社を回しています。
公的な認定・承認:神奈川県 経営革新計画 承認/経済産業大臣認定講座/厚生労働大臣指定講座/経済産業省 リスキリング補助事業者

 無料カウンセリング・お問い合わせ

 メールフォームからの