
新しいClaudeが出るたびに、「乗り換えるべき?」と迷っていませんか。
この記事では、Claude Fable 5.2の中身と料金、Opus 5.5との違いを、公式の数字だけで整理します。
同志社大学を卒業後、設備メーカーの海外営業を経て2016年に独立。旅行・医療などのメディアを自ら運営し、SEOとWeb広告で検索上位を数多く獲得してきました。いまはWebマーケティングスクールと法人研修を運営しながら、11部署57名のAIエージェントと会社を回しています。AIエージェントの作り込みにかけた時間は2,000時間以上です。スクールの卒業生は、ナイル、アイオイクス、サクラサクマーケティングなどのWebマーケティング会社へ転職しています。
公的な認定・承認:神奈川県 経営革新計画 承認/経済産業大臣認定講座/厚生労働大臣指定講座/経済産業省 リスキリング補助事業者
Claude Fable 5.2とは?Mythos 5.2との違いは「安全装置」だけ
Claude Fable 5.2は、Claudeのいちばん上の段のモデルです。
Anthropicが2026年11月9日(米国時間)に発表しました。
日本時間では11月10日の朝3時57分に、公式Xで発表されました。
同時に「Claude Mythos 5.2」も出ています。
公式の記事によると、FableとMythosは中身が同じモデルです。
違うのは、悪用を防ぐ安全装置(危ない頼みごとを止める仕組み)の有無です。
| 項目 | Claude Fable 5.2 | Claude Mythos 5.2 |
|---|---|---|
| 中身のモデル | 同じ | 同じ |
| 使える人 | 有料プランの全員・API | 申請して認められた組織 |
| 安全装置 | サイバー・生物の装置あり | 一部の装置を外して提供 |
| 向いている所 | 大きく答えの決まらない技術の仕事 | セキュリティ・生命科学の研究 |
Mythos 5.2を使うには、サイバーか生命科学の「確認プログラム」に申し込む必要があります。
一般の会社が使うのは、ほとんどの場合 Fable 5.2 です。
APIでのモデル名は claude-fable-5-2 です。
発表の元は、Claude公式アカウントが2026年11月10日(日本時間)に出した投稿です。
11月10日の時点で、表示は約234万回、いいねは約4.3万件でした(Claude公式Xの投稿)。
まずは公式の続きの投稿と記事を、日本語で順に見ていきましょう。
Claude Fable 5.2の性能は?Opus 5.5との違いをベンチマークで比較
Claude Fable 5.2は、公式の試験のほとんどでOpus 5.5とFable 5.1を上回りました。
公式Xでは「Opus 5.5より一段上」と紹介されています。
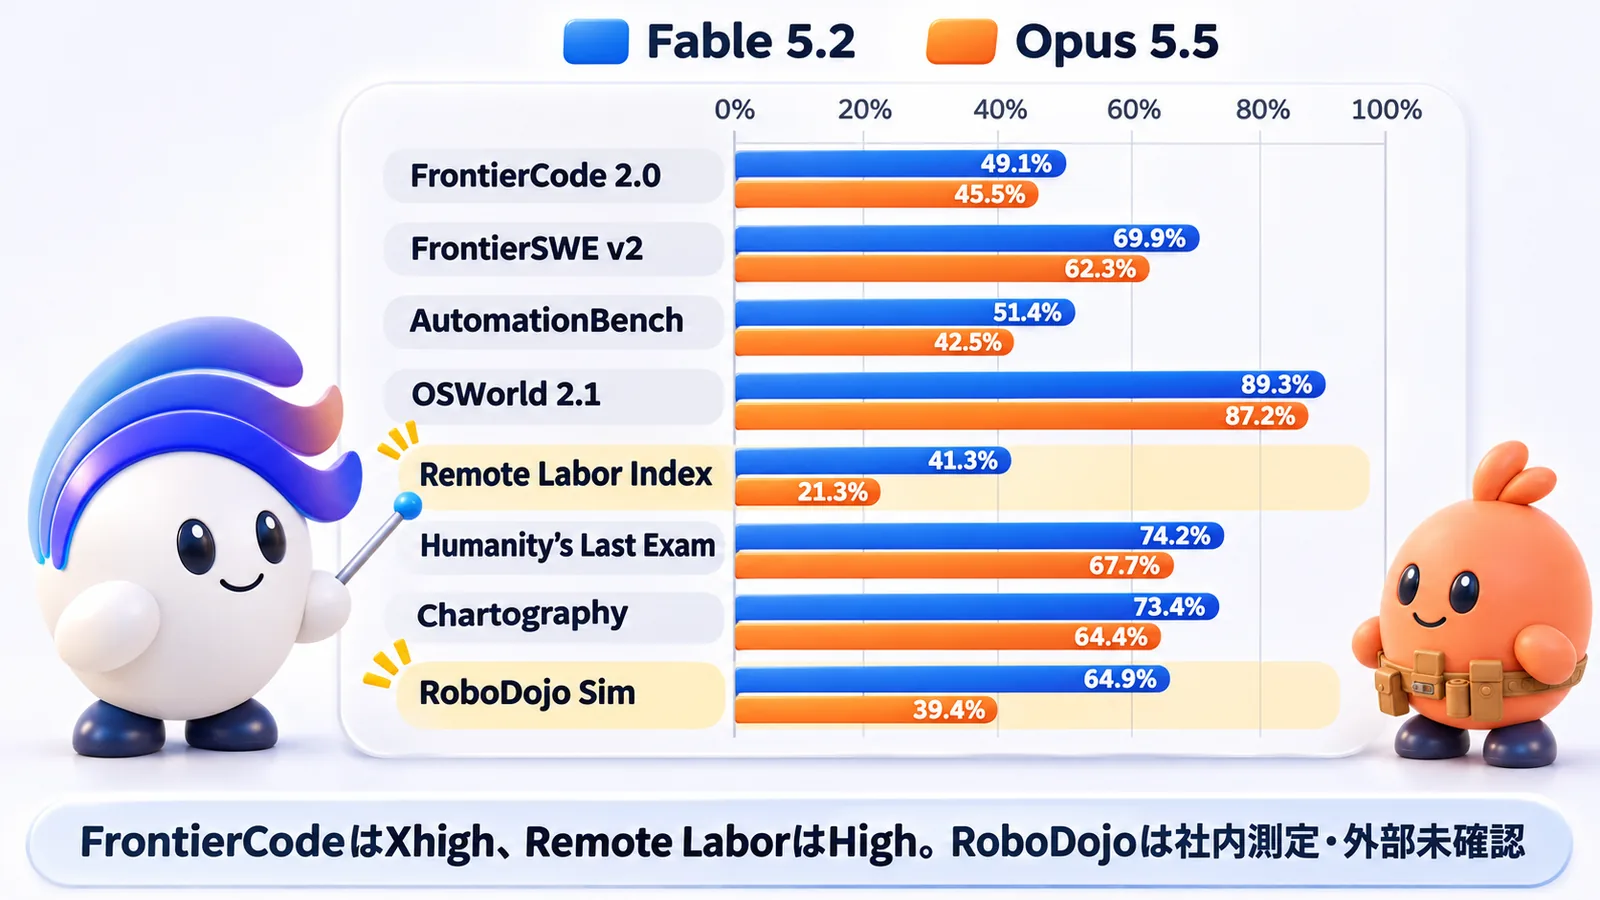
ベンチマーク(AIの力を測る共通の試験)から、仕事に近い8つを選びました。
| 試験(測るもの) | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|---|---|---|
| FrontierCode 2.0(難しい開発) | 49.1% | 32.4% | 45.5% |
| FrontierSWE v2(実務の修正) | 69.9% | 56.3% | 62.3% |
| AutomationBench(業務の流れ) | 51.4% | 31.4% | 42.5% |
| OSWorld 2.1(画面の操作) | 89.3% | 83.5% | 87.2% |
| Remote Labor Index(在宅の仕事) | 41.3% | 17.9% | 21.3% |
| Humanity’s Last Exam(難問・道具あり) | 74.2% | 65.6% | 67.7% |
| Chartography(グラフ読み取り) | 73.4% | 44.8% | 64.4% |
| RoboDojo Sim(ロボット操作) | 64.9% | 27.6% | 39.4% |
FrontierCode 2.0のFable 5.2・5.1は、考える量「Xhigh」での点数です。
Remote Labor IndexのFable 5.2は「High」での点数です。
差が大きい試験と、負けている試験
差が大きいのは、在宅でする仕事を任せる「Remote Labor Index」です。
Opus 5.5の21.3%に対して、Fable 5.2は41.3%でした。
ロボット操作の「RoboDojo Sim」も、39.4%から64.9%へ上がっています。
ただし公式は、これは社内で同じ条件で測った値で、外部の確認はまだと書いています。
一方で、業務の流れを測る「AutomationBench」では、他社モデルが上でした。
Gemini 4 Carbonが53.9%で、Fable 5.2の51.4%を上回っています。
他社モデルとの比較も、公式の表から抜き出しておきます。
| 試験 | Fable 5.2 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|
| FrontierCode 2.0 | 49.1% | 42.8% | 41.1% |
| FrontierSWE v2 | 69.9% | 65.5% | 61.2% |
| AutomationBench | 51.4% | 41.4% | 53.9% |
| OSWorld 2.1 | 89.3% | 79.5% | 81.5% |
試験の結果は、仕事の種類で強弱があります。
自社の仕事に近い試験の点数を見て、当てる仕事を決めるのが近道です。
Claude Fable 5.2の料金はいくら?値下げとfast modeの価格
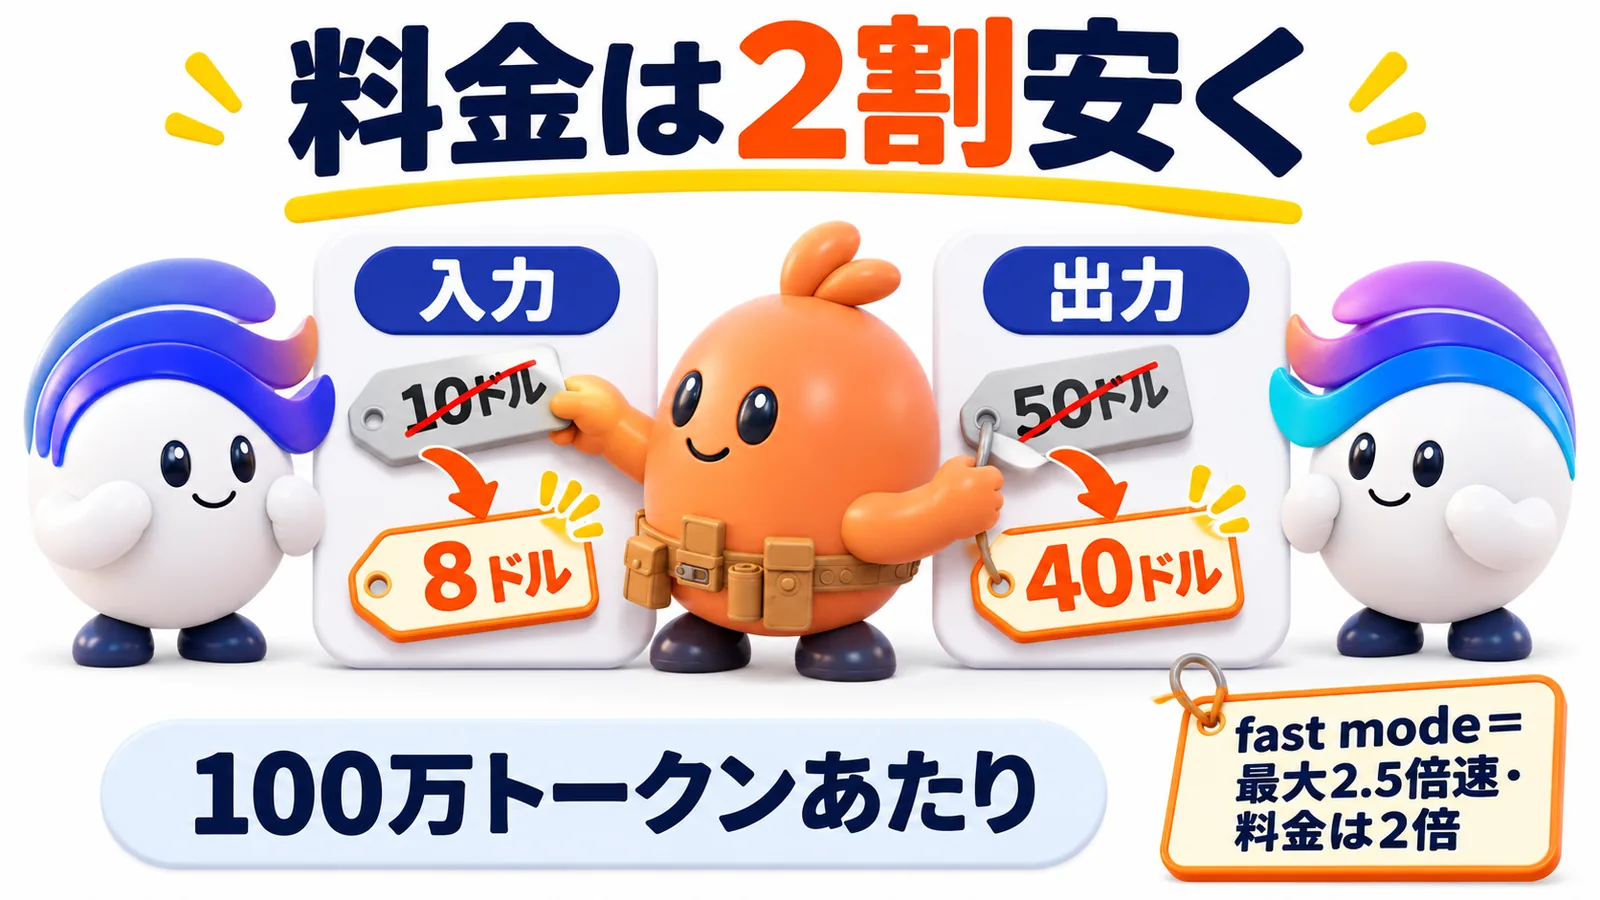
Claude Fable 5.2の料金は、100万トークンあたり入力8ドル・出力40ドルです。
公式Xによると、これまでの入力10ドル・出力50ドルから下がりました。
トークンは、AIが読み書きする文字の量をはかる単位です。
日本語なら、文字のかたまりの数と考えると分かりやすいです。
| 料金の種類 | これまで(公式Xより) | Fable 5.2 | fast mode |
|---|---|---|---|
| 入力(読ませる分) | 10ドル | 8ドル | 16ドル |
| 出力(書かせる分) | 50ドル | 40ドル | 80ドル |
料金はすべて100万トークンあたりです。
入力も出力も、2割安くなった計算です。
速さとfast mode
文章を書き出す速さは、Fable 5.1・Mythos 5.1より最大30%速くなりました。
さらに急ぎたいときは、fast modeを選べます。
文字を出す速さは最大2.5倍で、料金はふつうの2倍です。
fast modeを使える主な場所は、公式の記事では次の4つです。
- Claude Code
- Claude Platform
- Google CloudのClaude(Claude Models on Google Cloud)
- Microsoft Foundry
Mythos 5.2のfast modeは、確認プログラムに入った組織だけが使えます。
どこで使えるか
Fable 5.2は、発表の日からすべての提供先で使えます。
Claudeの全部の有料プランとClaude Platformで使えます。
AWS・Google Cloud・Microsoft Azureなどのクラウドでも使えます。
発表に合わせた期間限定の特典もあります。
ProプランとTeamの標準席では、1週間の利用枠の最大50%までFableを使えます。
契約の長さに応じて、Fableの利用枠のリセットが1〜3回もらえます。
Fable 5.2 のような新しいAIを、自分の仕事で使いこなしたい方へ
ニュースを読むだけで終わらせず、「どの仕事に、どのAIを当てるか」を実際の業務で身につけます。
- 個人の方:動画講座とマーケター適性診断。現役のWebマーケターに無料で相談できます
- 法人の方:自社の業務を題材にしたAIエージェント研修。資料請求と無料相談ができます
Claude Fable 5.2で費用が半分になる理由は?effort(考える量)の選び方
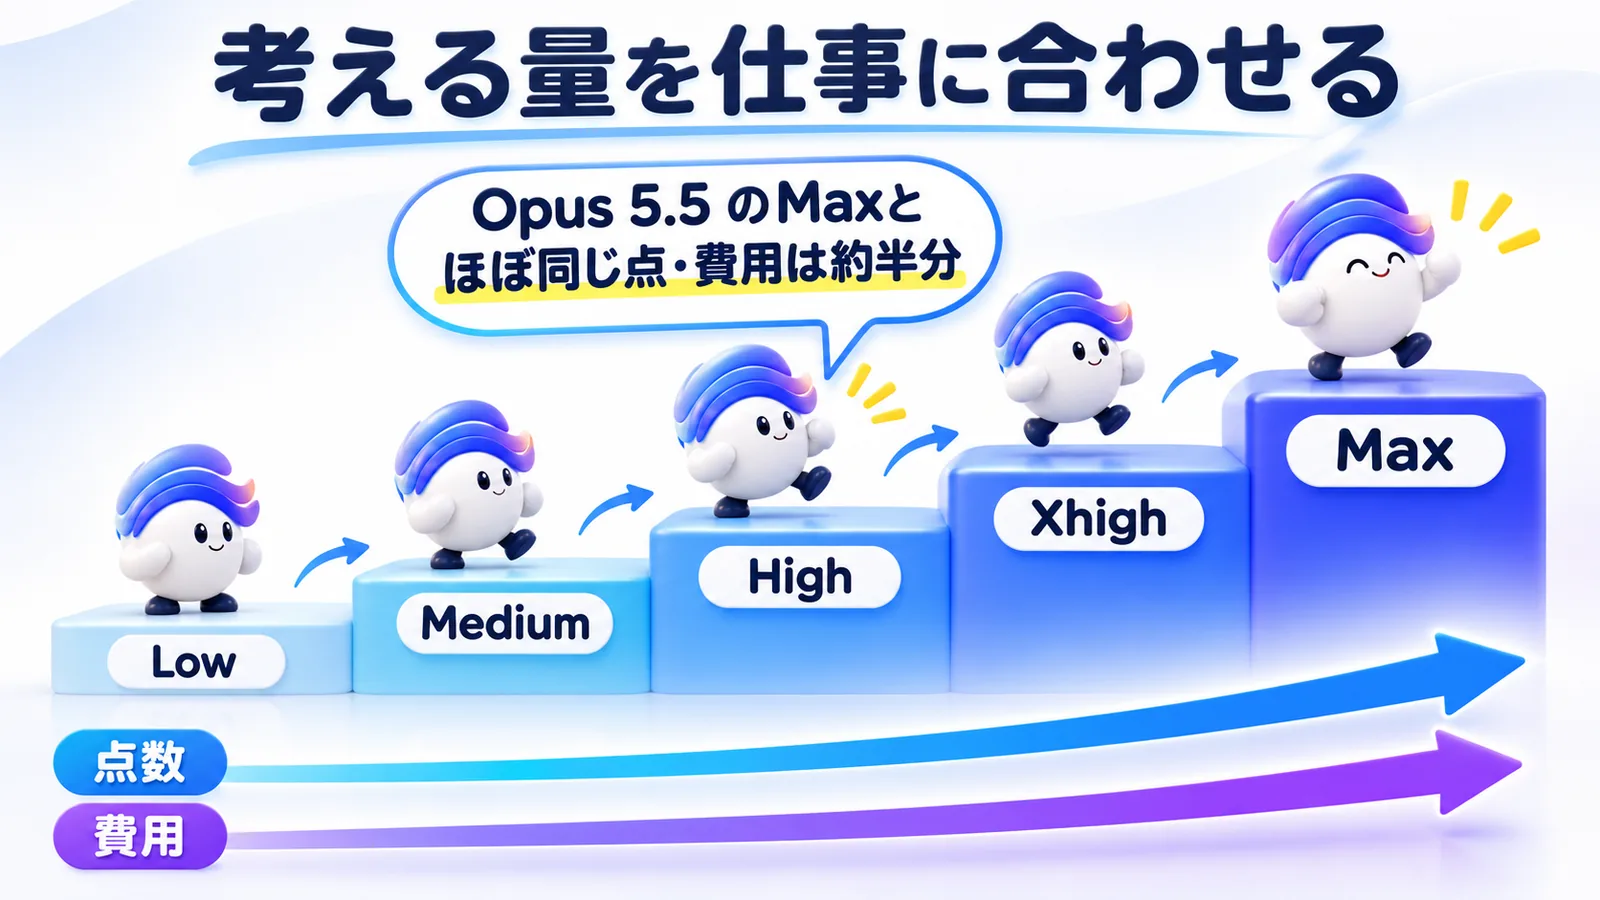
費用が下がる理由は、少ない「考える量」で、前のモデルの最高点に届くようになったからです。
FrontierCode 2.0では、HighのFable 5.2がOpus 5.5の最高点とほぼ同じ点でした。
しかも費用は約半分です。
effortとは
effort(エフォート)は、AIが1つの答えを出すまでに考える量の設定です。
たとえるなら、テストで見直しを何回するかを決めるつまみです。
段階は、Low・Medium・High・Xhigh・Maxの5つです。
Claudeのアプリと Claude Code では、Mediumが最初の設定になっています。
公式が示した「点数と費用」の比べ方
公式の記事には、考える量ごとの点数と費用を並べたグラフが5つ載っています。
文中で比べている結果を、表にまとめました。
| 試験 | Fable 5.2の設定 | 比べた相手 | 結果 |
|---|---|---|---|
| FrontierCode 2.0 | High | Opus 5.5の最高点 | 45.3%対45.5%・費用は約半分 |
| WANDR(調べもの) | Medium | Opus 5.5の最高点 | 同じ点を約40%の費用で |
| Humanity’s Last Exam | Low | Opus 5.5の最高点 | 同じ点を10分の1未満の費用で |
| Chartography | Medium | Opus 5.5のMax | 66.4%対64.4%・10分の1未満の費用 |
| BenchCAD 2.1 | Max | Opus 5.5 | 83.5対65.3 |
FrontierCode 2.0では、Xhighまで上げると49.1%でした。
公式Xでは、試された公開モデルの中で最高点と紹介されています。
ここから分かるのは、強さを上げれば上げるほど得、ではないということです。
仕事によっては、LowやMediumで十分に前のモデルの最高点に届きます。
強さの選び方の目安
公式の数字をもとに、私たちは次の順で試すことをおすすめしています。
- まずは最初の設定のMediumで試す
- 出来が足りなければHighへ上げる
- 数時間かかる難題だけ、XhighやMaxを試す
Claude Fable 5.2とOpus 5.5の使い分けは?公式のおすすめ
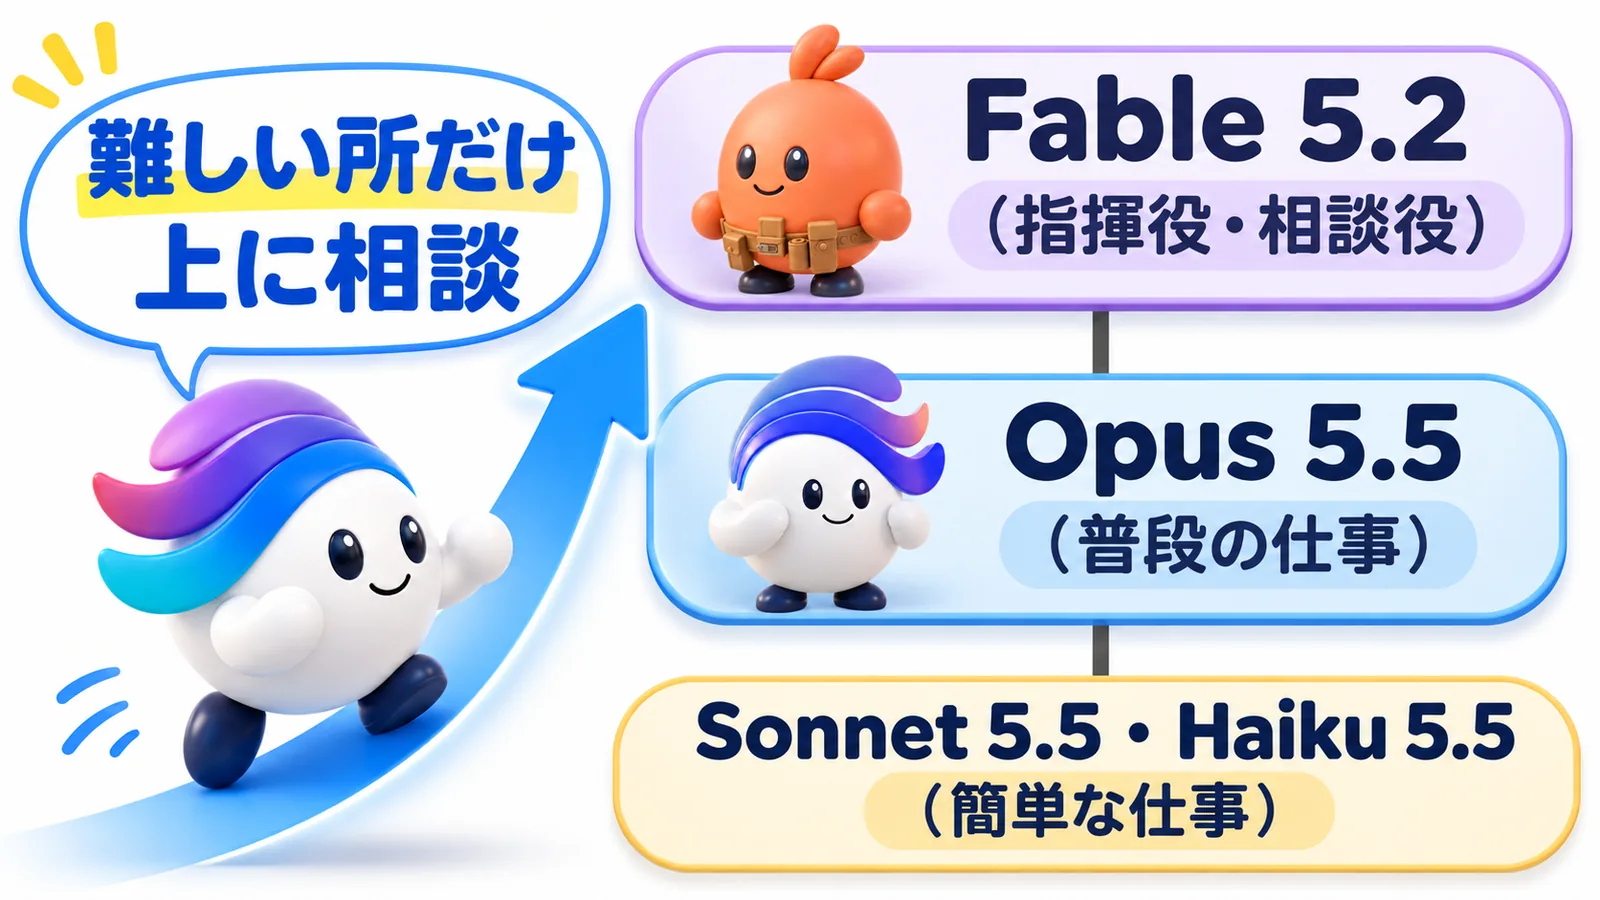
公式のおすすめは、普段の仕事はOpus 5.5、大きくて答えの決まらない技術の仕事はFable 5.2です。
Anthropicは、Opus 5.5を「いちばん強い普段使いのモデル」と位置づけています。
公式の記事では、ほとんどの開発や知識の仕事は、まずOpus 5.5から始めるよう書かれています。
そこから難しい仕事は上へ、簡単な仕事は下へ動かす考え方です。
| 段 | モデル | 当てる仕事 |
|---|---|---|
| 上の段 | Fable 5.2・Mythos 5.2 | 大きく答えの決まらない技術の仕事 |
| 普段 | Opus 5.5 | ほとんどの開発・知識の仕事 |
| 下の段 | Sonnet 5.5・Haiku 5.5 | 簡単な仕事 |
相談役(Advisor)と指揮役(Orchestrator)
Fable 5.2は、ほかのモデルと組み合わせて使う方法も紹介されています。
- 相談役(Advisor):Haiku・Sonnet・Opusが、難所だけFable 5.2に相談する使い方です。
- 指揮役(Orchestrator):Fable 5.2が段取りを考え、簡単な作業を小さなモデルに振る使い方です。
会社にたとえると、ベテランの部長に全部の作業をさせない形です。
難しい判断だけ相談し、段取りだけ組んでもらうので、費用を抑えられます。
導入企業のDatadogの技術者も、近い見方をしています。
障害対応の指揮をとる人のように、速いモデルを送り出して手がかりを集められる、という趣旨です。
Claude Fable 5.2は何ができる?公式の事例7つ
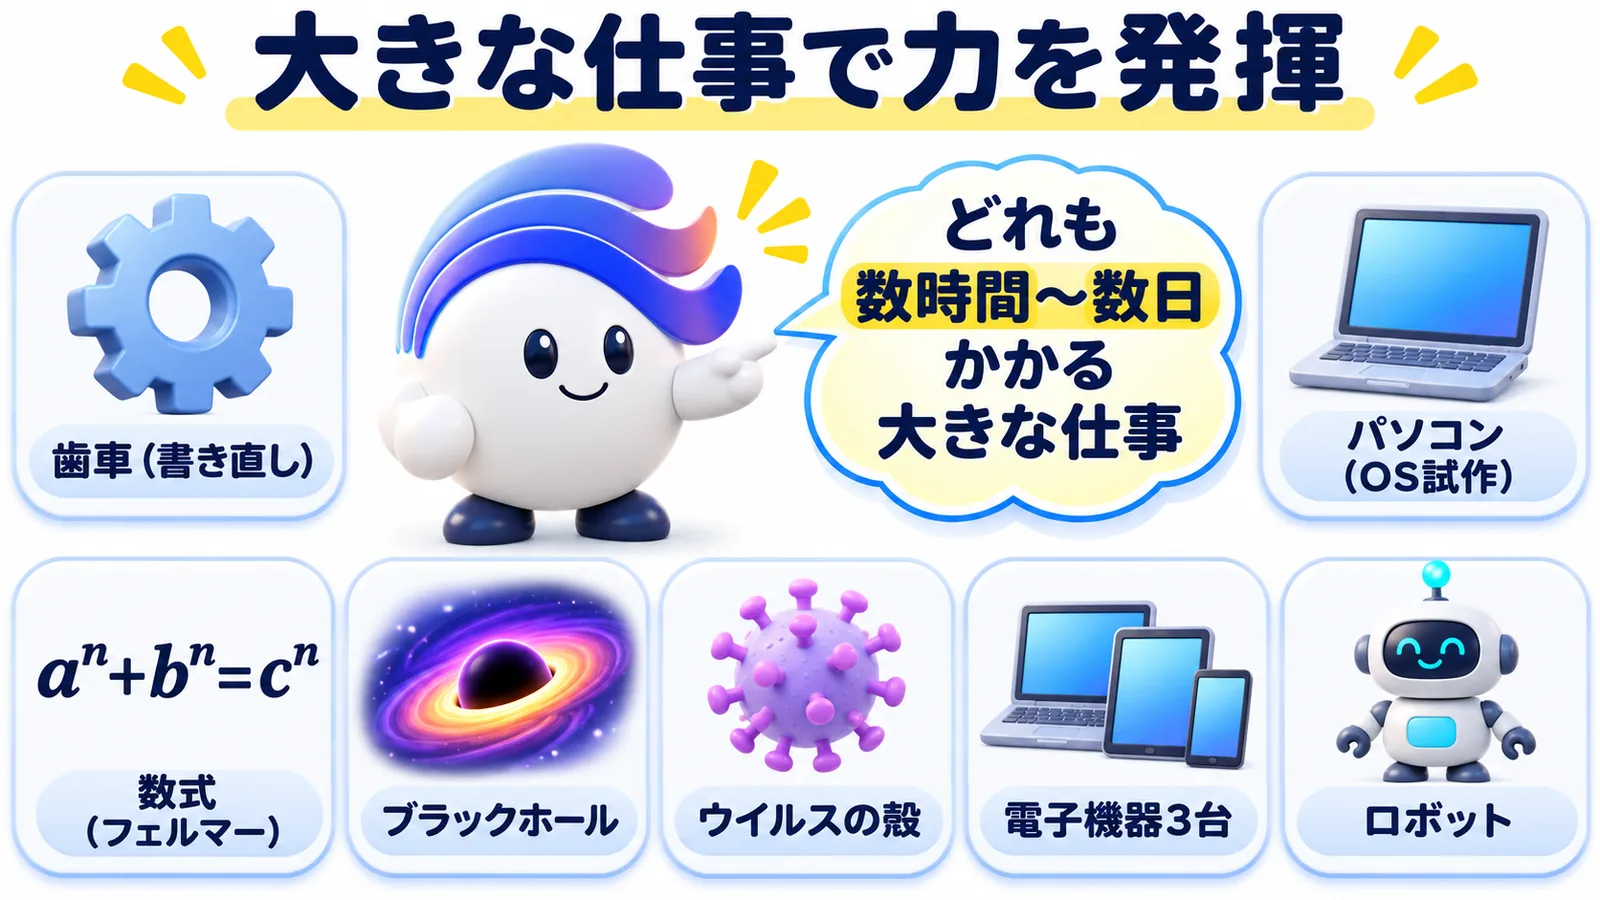
Claude Fable 5.2は、数時間から数日かかる大きな仕事を、最後までやり切った事例が多く出ています。
公式の記事から、分かりやすい7つを選びました。
1. PythonからRustへの書き直し
Fable 5.2の開発途中の版を使ったAIのチームが、本番のサービスを書き直しました。
Rustは、速く動くことで知られるプログラミング言語です。
書き直したサービスは、起動が約26倍速くなったと公式は書いています。
2. 空のフォルダから基本ソフトを試作
1人の技術者が、空のフォルダを渡して作業を任せました。
Fable 5.2は1,000体を超える小さなAIをまとめ、8日間休まず作業しました。
できた試作はノートパソコンで起動し、ログイン画面やインストーラーまで備えていました。
3. フェルマーの最終定理を約30時間で形式化
約1,000体のFable 5.2が、有名な定理の証明を「機械が確かめられる形」に書き切りました。
使った言語はLeanで、かかった時間は約30時間です。
同じ仕組みのOpus 5.5は、18時間で26%まで進み、30時間でもほとんど進みませんでした。
以前、公開前のClaudeで同じことをしたときは、11日かかったそうです。
4. 物理学の未解決問題
ブラックホールに関する、2つの未解決の問題に取り組みました。
2003年に「計算が大変すぎて終わらなかった」計算を、ほぼ自力でやり切った例もあります。
結果は論文の下書き(プレプリント)として公開されています。
出典:hexagonmath.org プレプリント 2611.00175v1。公式記事が物理学の成果として示した論文の下書きの1本目です。
出典:hexagonmath.org プレプリント 2611.00174v1。同じく、2つ目の問題の論文の下書きです。
5. ウイルスの殻の形の予想
遺伝子治療に使われるウイルスの殻(AAVカプシド)の形の予想に挑みました。
Mythos 5.2は、試した34個のうち28個を正しく組み立てました。
既存の公開された予想の道具を組み合わせ、殻の対称な形を使ってつなぐ方法です。
6. 電子機器を3台設計
家庭用の音声アシスタントの親機、USBのスピーカーフォン、手のひらサイズのペット育成機です。
回路の板・ケース・ソフトまで設計し、3台とも電気の手直しなしで動きました。
7. ロボットの操作
RoboDojo Simで64.9%を出し、比べたほかのモデルを上回りました。
Anthropic社内でも
公式の記事によると、Anthropicの中心のプログラムの変更は、90%以上をいまClaudeが書いています。
人が方向を示しながら、という条件つきです。
導入企業の声(日本語で要旨)
先に試した企業の声も、公式の記事に多く載っています。
実務に近いものを、日本語で要点だけまとめました。
- Vercel:何週間も止まっていた計画が、数日で承認まで進んだ。
- Uber:約170体の点検役のAIで、10〜12時間のセキュリティ点検を回した。
- Oracle:集計で正しい値を返した。比べた別の2モデルは5〜8倍の値を出した。
- Snowflake:103個のデータ整備の課題で、測った中で最も強いモデルだった。
- Cognition:分からないことは、でたらめを作らず「分からない」と言う。
- Box:融資書類で、給料の入金と口座の残高の食い違いを指摘した。
「正しく数える」「分からないと言う」「食い違いを見つける」という声が目立ちます。
派手な成果だけでなく、仕事のミスを減らす方向の評価が多いのが特徴です。
Claude Fable 5.2の安全性は?サイバー・生物の安全装置
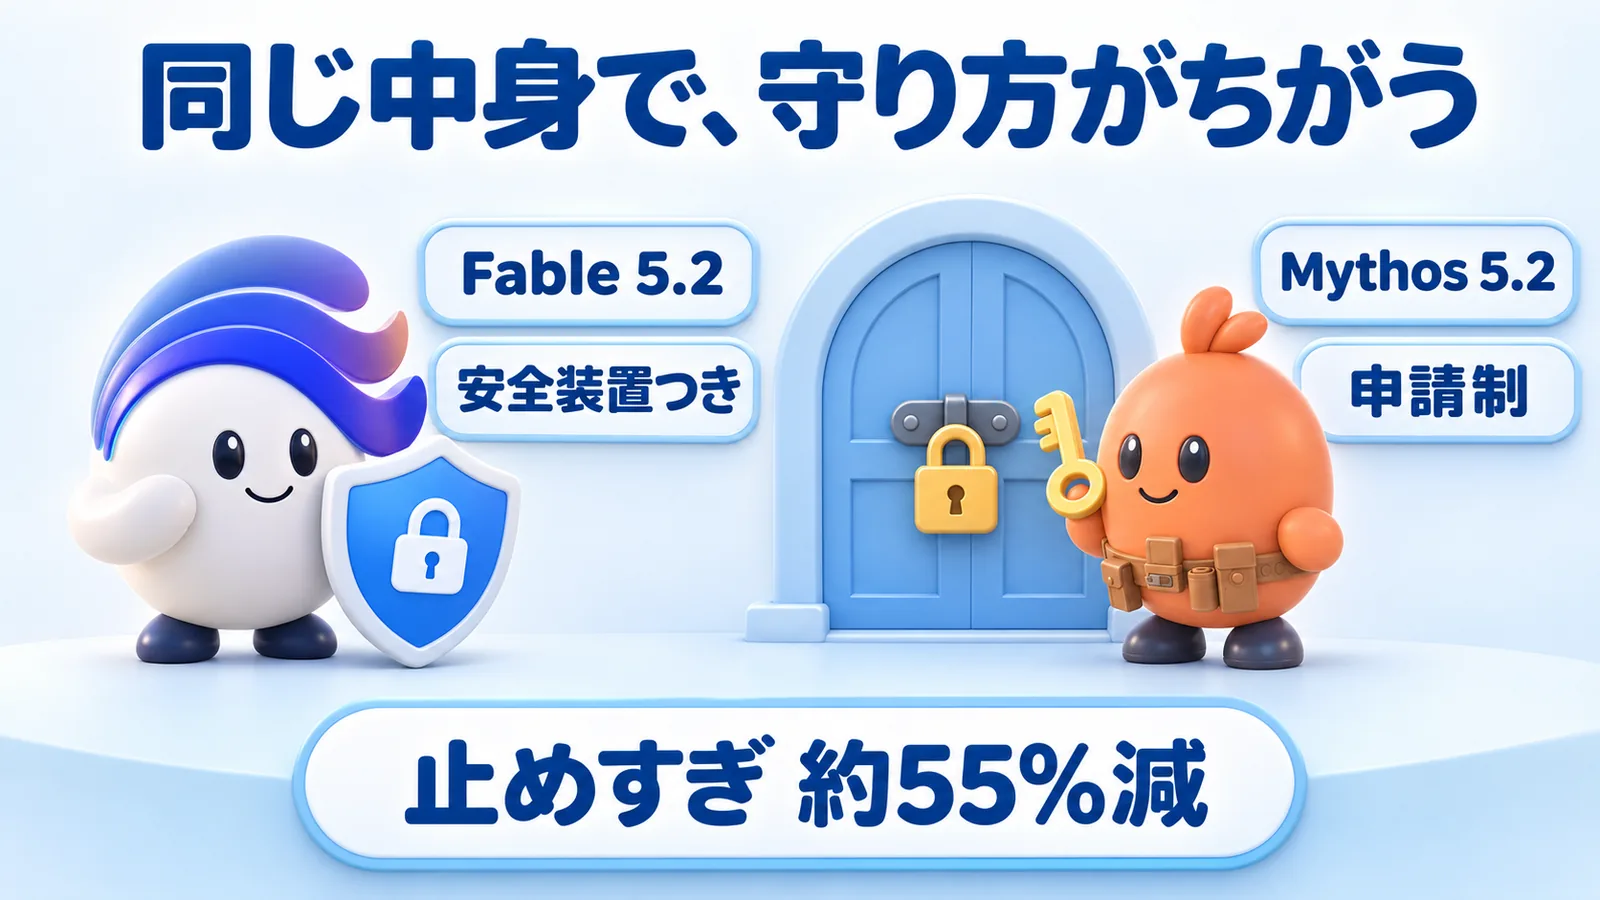
Claude Fable 5.2には、サイバー攻撃と生物の研究の悪用を防ぐ安全装置がついています。
同じ中身のMythos 5.2は、申請制にすることで安全を守っています。
Fable 5.2で止まる仕事
公式の記事では、Fable 5.2で止まる仕事として次が挙がっています。
- 侵入テストや、攻撃に使うプログラムづくり
- プログラムの中身から弱点を探す作業
- 研究用の生物の作業の多く
止まった頼みごとは、サイバーならOpus 4.8、生物ならOpus 5に回される作りです。
「止めすぎ」は約55%減った
安全装置の強さは前のFable 5.1と同じくらいのまま、必要のない止めすぎが減りました。
全体で約55%減り、サイバーで約60%、生物で約40%減ったと公式は説明しています。
サイバーの力はMythos 5.2が担当
Mythos 5.2は、過去の弱点(CVE)を見つけ直す試験で89.6%でした。
Opus 5.5より10.2%、Mythos 5.1より14.4%多く見つけています。
この試験は、2026年10月に1,829件の弱点で行われたものです。
安全面の評価
公式は、大きな害につながる「ずれ」の危険は低いと評価しています。
約1,900の場面で行った行動の点検(低いほど良い・10段階)では、Mythos 5.2は2.67でした。
Opus 5.5は2.79でした。
閉じた環境の外の情報を使おうとした割合は、Mythos 5.2が3.1%、Opus 5.5が3.3%でした。
この試験は1,800を超える場面で行われています。
会社で使うときに押さえたいこと
モデル側の安全装置があっても、使う側の決まりは別に必要です。
日本の公的機関も、AIを使う人向けの注意点を出しています。
出典:IPA「AI利用者のためのセキュリティ豆知識」(2026年4月2日公開)。クラウド型のAIに営業秘密を入れない、社内と社外の情報を混ぜない、といった利用者向けの注意点がまとまっています。
出典:Japan AISI(AIセーフティ・インスティテュート)。IPAが運営し、AIの安全性を測る方法や基準を検討・普及している機関です。
Claude Fable 5.2を実務にどう当てる?記事・広告・集計・社内ツール
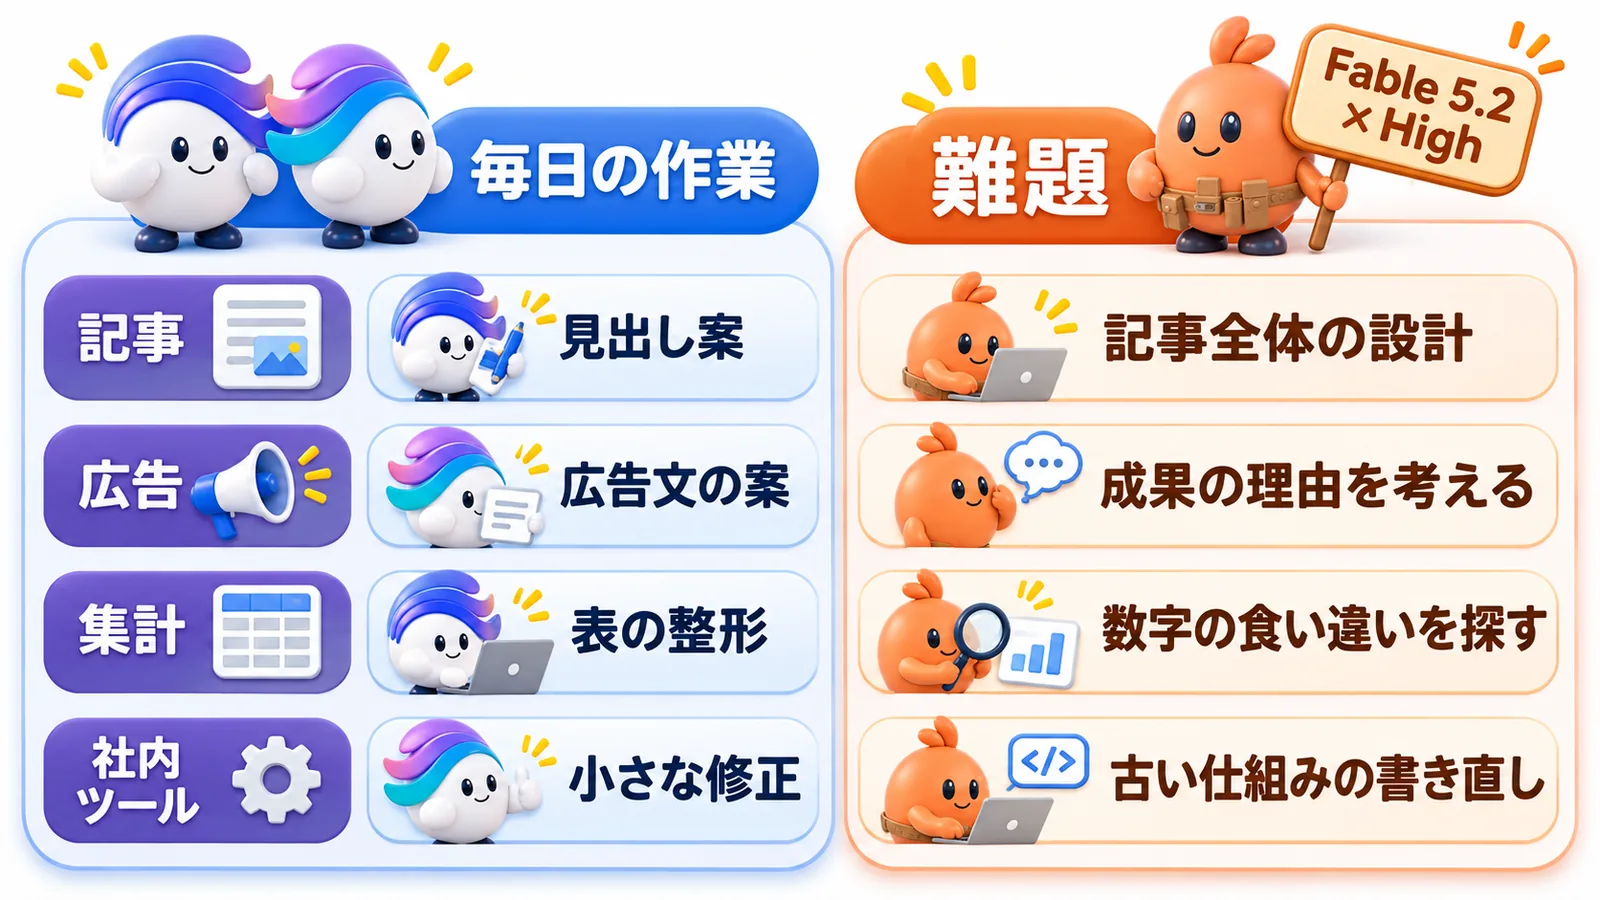
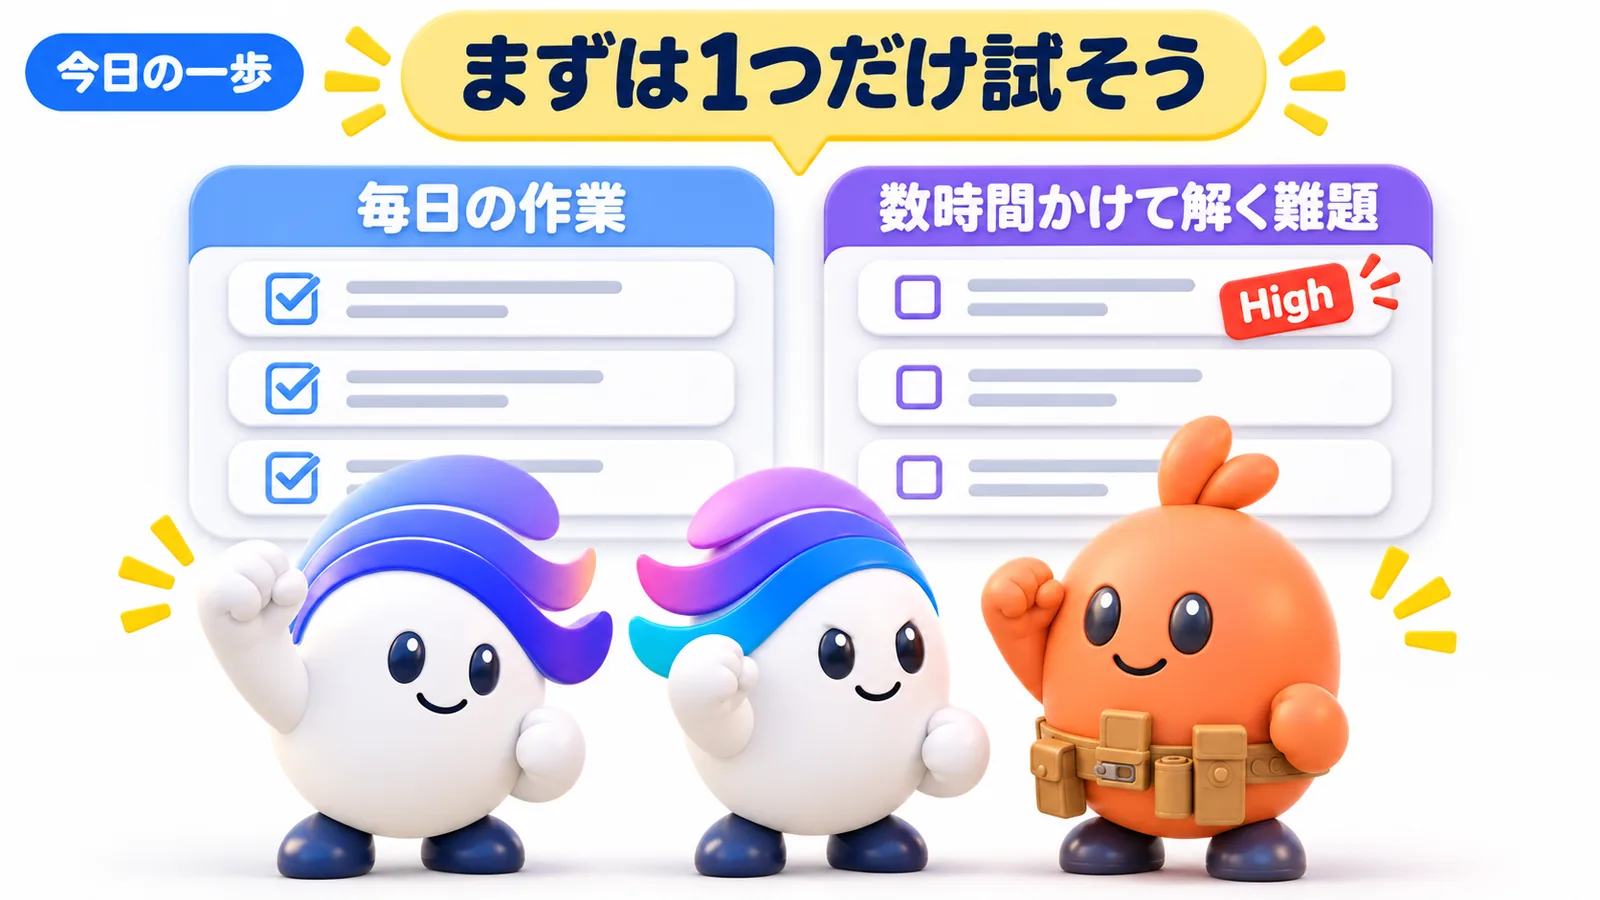
実務での当て方は、同じ業務の中の「毎日の作業」と「数時間かけて解く難題」を分けることです。
難題の側だけにFable 5.2のHighを当て、毎日の作業はOpus 5.5以下で回します。
日本でも、会社のAI導入は広がっています。
IPAの調査報告書は、AIの活用の実態・効果・課題や体制づくりを扱っています。
出典:IPA「DX動向2026 広がるAI導入、DXは変われるか」(2026年7月30日公開)。日本企業のAI活用の実態・効果・課題・体制を調べた報告書です。
4つの場面の仕分け表
| 場面 | 毎日の作業(Opus 5.5以下) | 難題(Fable 5.2を試す) |
|---|---|---|
| 記事づくり | 見出し案・下書き・言い回し | 100本の記事全体の設計 |
| 広告 | 広告文の案出し | 3か月分の勝ち負けの理由づけ |
| データ集計 | 表の整形・月次まとめ | 複数データの食い違い探し |
| 社内ツール | 小さな修正・説明文 | 古い仕組みの書き直し・試作 |
記事づくり
たとえば、毎週ブログを書いている会社のときです。
見出し案や言い回しの直しは、毎日の作業です。
Opus 5.5、軽いものならSonnet 5.5で足りることが多いでしょう。
一方、100本の記事で何を狙い、どう分類するかを決める設計は難題です。
答えが1つに決まらず、間違えたときの損も大きいからです。
ここでFable 5.2のHighを試す価値があります。
広告
たとえば、ネット広告を自社で回しているときです。
広告文を10案出すのは、毎日の作業です。
3か月分の成果を見て、どの広告がなぜ当たったかを考えるのは難題です。
数字と画面と文を見比べて理由を立てる仕事に、上の段のモデルを当てます。
データ集計
たとえば、売上表と請求記録と広告の管理画面の数字が合わないときです。
どこでずれたかを探す作業は、人だと半日かかることもあります。
OracleやBoxの声のように、Fable 5.2は「正しく数える」「食い違いを見つける」で評価されています。
こうした場面は、試す候補の代表です。
毎月同じ形にまとめるだけなら、Opus 5.5以下のほうが安く済みます。
社内ツール
公式のPython→Rustの例のように、大きな書き直しはFable 5.2の得意分野です。
ボタンの文字を変えるような小さな直しは、毎日の作業として扱います。
迷ったときの3つの質問
- 答えが1つに決まっているか(決まっていれば毎日の作業)
- 人がやると数時間以上かかるか(かかれば難題の候補)
- 間違えたときの損が大きいか(大きければ難題の候補)
人の確認は残す
どのモデルを使っても、最後に人が確かめる工程は残しましょう。
国の行政でも、生成AIの活用とリスク管理を一体で進める方針が出ています。
出典:デジタル庁「行政の進化と革新のための生成AIの調達・利活用に係るガイドライン」(2025年5月27日公開)。政府の業務で生成AIの活用を進めながら、リスク管理を一体で行うためのガイドラインです。最新版はデジタル社会推進標準ガイドライン(DS-920)に掲載されています。
そのまま使える「仕分け」の依頼文
私の今週の仕事を下に書きます。
それぞれを「毎日の作業」と「数時間かけて解く難題」の2列に分けてください。
分けた理由を1行ずつ添えてください。
最後に、難題の列から「最初にFable 5.2のHighで試すと良さそうな仕事」を1つ選び、理由を教えてください。
(ここに今週の仕事を箇条書きで書く)
WEBMARKSの実測:書き手AIの比較で見えた「割り振り」の効き目
私たちWEBMARKSでも、モデルの割り振りで費用が大きく変わることを実測しています。
2026年11月初めに、記事の書き手のAIを2つ比べた結果です。
同じ条件で記事を書かせ、別のAIに点数をつけさせました。
| 書き手のAI | 点数 | 1本あたりの費用 |
|---|---|---|
| Opus 5.5(考える量:High) | 71点 | 約0.79ドル |
| 別の会社のモデル | 68点 | 約0.13ドル |
点数は3点差でほぼ同じでした。
一方で、1本あたりの費用は約6倍の差がありました。
この結果を受けて、私たちは記事の下書きのような毎日の作業に、安いモデルを当てています。
そのぶん、設計や点検のような難題に、強いモデルを回しています。
Fable 5.2の公式の数字と、私たちの手元の数字は、同じことを示しています。
性能の差より、割り振りの差のほうが、費用に大きく効くということです。
私たちが割り振りで決めていること
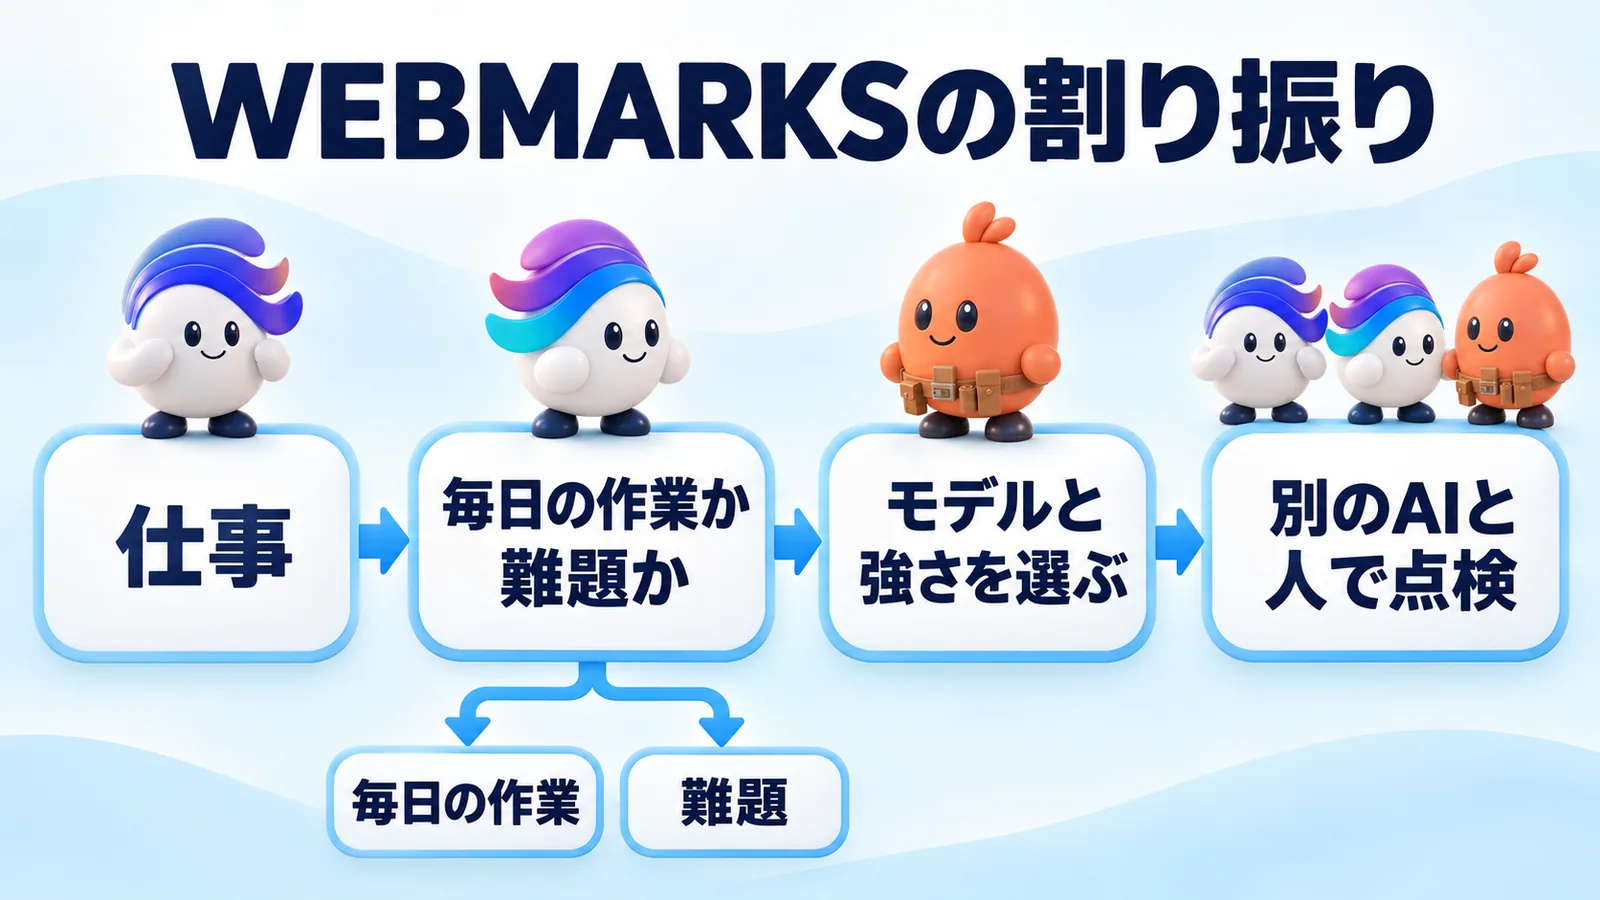
- 仕事ごとに「毎日の作業」か「難題」かを先に決める
- 毎日の作業は、点数が足りる範囲でいちばん安いモデルにする
- 難題には強いモデルを当て、強さ(effort)は低い方から試す
- 出来は、作り手とは別のAIと人の目で点検する
Fable 5.2 のような新しいAIを、自分の仕事で使いこなしたい方へ
ニュースを読むだけで終わらせず、「どの仕事に、どのAIを当てるか」を実際の業務で身につけます。
- 個人の方:動画講座とマーケター適性診断。現役のWebマーケターに無料で相談できます
- 法人の方:自社の業務を題材にしたAIエージェント研修。資料請求と無料相談ができます
Claude Fable 5.2のよくある質問
Q. Claude Fable 5.2はいつから使えますか?
2026年11月9日(米国時間)の発表の日から使えます。
日本時間では11月10日の朝です。
Claudeの有料プランとClaude Platformで提供されています。
AWS・Google Cloud・Microsoft Azureなどでも使えます。
Q. Claude Fable 5.2の料金はいくらですか?
100万トークンあたり、入力8ドル・出力40ドルです。
公式Xによると、これまでの入力10ドル・出力50ドルから下がりました。
fast modeは入力16ドル・出力80ドルです。
Q. Claude Fable 5.2とOpus 5.5の違いは何ですか?
Fable 5.2は、Opus 5.5より一段上のモデルです。
FrontierCode 2.0では、HighのFable 5.2がOpus 5.5の最高点とほぼ同じ点でした。
しかも費用は約半分です。
ただし公式は、普段の仕事はまずOpus 5.5から始めるようすすめています。
Q. Claude Fable 5.2とMythos 5.2は何が違いますか?
中身は同じモデルです。
Fable 5.2には、サイバーと生物の悪用を防ぐ安全装置がついていて、誰でも使えます。
Mythos 5.2は、確認プログラムで認められた組織だけが使えます。
Q. effort(考える量)はどれにすればいいですか?
アプリとClaude Codeの最初の設定はMediumです。
まずMediumで試し、出来が足りなければHighへ上げる順がおすすめです。
公式の数字では、LowやMediumでもOpus 5.5の最高点に届く試験がありました。
まとめ:Claude Fable 5.2は「当て方」で差がつく
Claude Fable 5.2の本当の変化は、1つの仕事の費用が約半分になったことです。
だからこそ、どの仕事に、どのモデルを、どの強さで当てるかで差がつきます。
今日からできる行動は、次の3つです。
- 自分の仕事を「毎日の作業」と「数時間かけて解く難題」の2列に分ける
- 難題の列から1つだけ選び、いつものモデルとFable 5.2のHighで同じ頼みごとをする
- 出来と費用を比べてメモし、次に当てる仕事を決める
小さく1回試すだけで、ニュースの「すごい」が、自分の仕事の「使える」に変わります。
この話題をSNSでも
- X:発表の要点を6つの投稿にまとめました(スレッドを見る)
- X(毎日):AIエージェントの最新の動きを、毎日わかりやすく発信しています(@WEBMARKS2)
- Instagram:AIの使い方を、図とリールで紹介しています(@webmarks_official)
出典一覧
公式(一次情報)
– Anthropic「Claude Fable 5.2 and Claude Mythos 5.2」(2026年11月9日・米国時間)https://www.anthropic.com/claude-fable-and-mythos-5-2 (2026年11月10日確認)
– Claude公式X(2026年11月10日 3:57 日本時間)https://x.com/claudeai/status/2119867114450268322 (2026年11月10日確認)
– hexagonmath.org プレプリント 2611.00175v1 https://hexagonmath.org/2611.00175v1
– hexagonmath.org プレプリント 2611.00174v1 https://hexagonmath.org/2611.00174v1
公的機関
– IPA「AI利用者のためのセキュリティ豆知識」https://www.ipa.go.jp/digital/ai/security/ai_security_tips.html (2026年11月10日確認)
– IPA「DX動向2026 広がるAI導入、DXは変われるか」https://www.ipa.go.jp/digital/chousa/dx-trend/dx-trend-2026.html (2026年11月10日確認)
– デジタル庁「行政の進化と革新のための生成AIの調達・利活用に係るガイドライン」https://www.digital.go.jp/news/3579c42d-b11c-4756-b66e-3d3e35175623 (2026年11月10日確認)
– Japan AISI(AIセーフティ・インスティテュート)https://aisi.go.jp/ (2026年11月10日確認)
自社の実測
– WEBMARKS 記事の書き手AIの比較(2026年11月初め・社内記録)

 無料カウンセリング・お問い合わせ

 メールフォームからの